
智谱认领“牛来”模型,实测:“牛马”友好
过去一个周末,全球AI开发者都在追问同一个问题:突然出现在 OpenRouter 上的神秘模型Ox Alpha,究竟来自哪家实验室?
它没有公布开发者,没有披露参数规模,也没有给出技术报告,只以“匿名模型”的身份开放使用。
但在短短几天内,Ox Alpha迅速冲上OpenRouter热门榜单,并凭借代码生成、复杂推理和长时间Agent任务中的表现,引发了大量猜测。
“牛来”模型谜底揭晓,是 GLM-5.3-Flash
现在,谜底终于揭晓。
昨天晚上,智谱正式确认:Ox Alpha 正是其最新发布的 GLM-5.3-Flash。过去一周在海外开发者社区引起轰动的“神秘模型”,真的来自智谱。
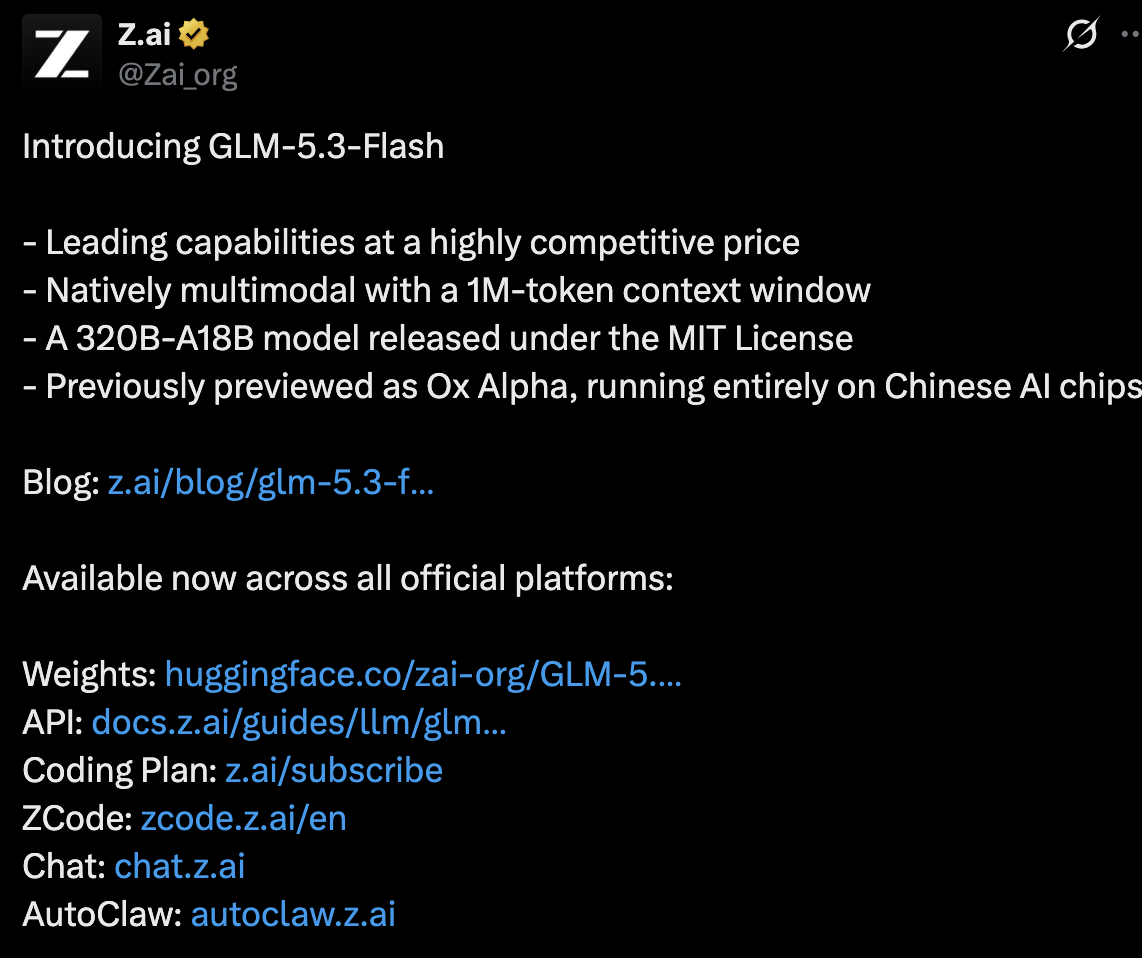
Ox Alpha最早于8月20日匿名登陆OpenRouter。
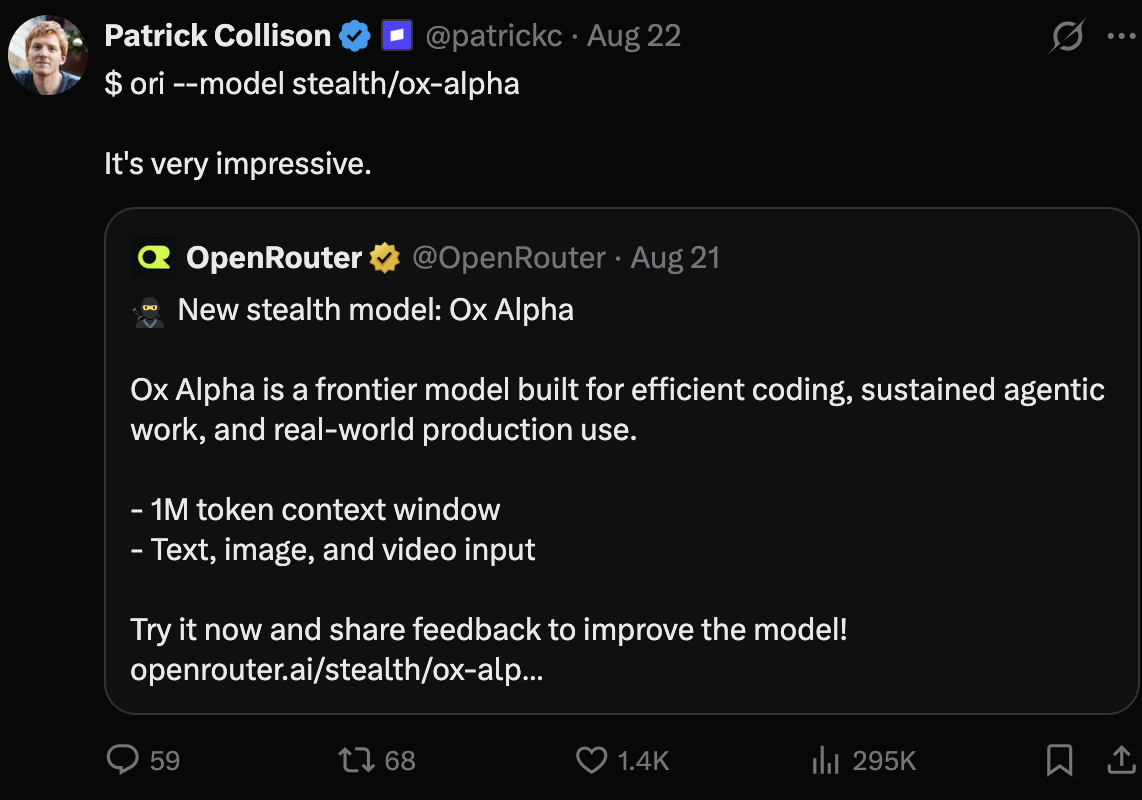
在身份揭晓前,OpenRouter对它的描述是:一款面向代码、持续智能体工作和生产负载设计的推理模型,适合处理长期软件工程、复杂推理,以及结合文本和视觉信息的工作流。
它可以接收文本、图片和视频输入,输出文本,匿名测试版本提供104万Token上下文。
OpenCode 还曾宣布向用户免费开放一周,并称模型提供方准备了每天100万亿Token的服务能力。
这种近乎“无限量免费”的测试方式,让Ox Alpha在几天内获得了大量真实用户。
Stripe 联合创始人兼 CEO Patrick Collison 体验后表示,它“非常令人印象深刻”。
一部分开发者则发现,Ox Alpha在代码修改、前端生成、理解大型代码仓库以及连续调用工具方面,表现并不像一款普通的低成本模型。
外界对其身份的猜测也由此升温。
事实证明,Ox Alpha 并非智谱在 GLM 之外另起炉灶,而是 GLM-5 系列中的新成员——GLM-5.3-Flash。匿名上线更接近一次大规模公开盲测:先隐藏厂商和模型名称,让开发者根据实际使用效果作出判断,再公布身份和技术细节。
智谱此前也采用过类似方式测试 Pony Alpha。相比直接发布基准测试成绩,匿名测试能够在一定程度上减少品牌认知对评价的影响,也能在正式发布前获得更大规模的真实负载和用户反馈。
根据智谱官方博客,Ox Alpha 在 OpenCode 和 OpenRouter 开放期间,一度成为当周最受欢迎的模型。
更加值得注意的是,匿名测试期间产生的全部流量,均由部署在国产AI芯片上的大规模集群承载。
新模型怎么样?
GLM-5.3-Flash是一款混合专家模型,拥有3200亿总参数,但每次处理Token时只激活约180亿参数。
这意味着,它保留了大模型的参数容量,但不需要在每次推理时调用全部3200亿参数。
模型会根据输入内容,将任务分配给部分专家网络,在模型能力、推理速度和部署成本之间寻找平衡。
与GLM-4.5系列相比,两者的总参数量接近,分别为3200亿和3550亿,但GLM-5.3-Flash的激活参数从320亿下降到180亿,模型层数也由92层减少至45层。
激活参数和层数减少,可以直接降低单个Token推理时需要完成的计算量。
这也是GLM-5.3-Flash名称中“Flash”的一层含义:它并非简单缩小模型,而是希望通过架构变化,用更少的实际计算量保留接近大型模型的能力。
GLM-5.3-Flash还是GLM-5系列中第一款原生多模态模型,可以同时处理文本、图片、视频和文件,并提供约100万Token上下文窗口。
智谱称,该模型采用了最新的30万亿Token多模态预训练语料。这意味着其视觉能力并非在纯文本模型训练完成后简单外挂,而是在预训练阶段便将文本与视觉信息纳入统一模型。
模型权重目前已经在Hugging Face开放,并采用相对宽松的MIT许可证。开发者可以通过SGLang、vLLM、KTransformers和TokenSpeed等框架进行本地部署。
模型地址:https://huggingface.co/zai-org/GLM-5.3-Flash"
具体而言,新模型有哪些亮点值得关注?
亮点一:重新设计的注意力机制
首先是为百万 Token 上下文重新设计的注意力机制。
长上下文一直是大模型推理成本增长最快的部分之一。
模型需要记住的内容越多,注意力计算量和KV Cache占用的显存就越大。当上下文扩展到100万Token后,如果继续沿用传统注意力机制,服务成本和硬件压力都会明显上升。
为了降低这部分开销,GLM-5.3-Flash 采用了线性注意力与稀疏注意力结合的混合架构。智谱将其称为首个采用这种混合架构的开源前沿模型。
其中,线性注意力主要通过状态建模捕捉局部依赖;稀疏注意力则通过轻量级索引器,从更长的上下文中寻找与当前任务相关的信息。
简单来说,模型不必在每一次生成时都让所有Token彼此进行完整计算,而是先利用线性注意力处理局部信息,再从百万Token上下文中检索真正相关的全局内容。
为进一步降低百万Token场景下索引器的延迟和内存占用,智谱还设计了IndexPool,通过加权池化将四个索引器Key向量压缩为一个。
按照智谱给出的测算,与GLM-5.3相比,GLM-5.3-Flash的注意力计算量降至约三分之一,KV Cache规模降至约四分之一,分别减少3.01倍和4.44倍。
不过,智谱也没有回避它与其他模型之间的差距。
在其对GLM-5.3、DeepSeek-V4-Flash 和 Kimi-K3 的对比中,GLM-5.3-Flash 的注意力计算量最低,但 KV Cache 仍然略大于 Kimi-K3 和 DeepSeek-V4-Flash,说明其显存效率仍有进一步优化空间。
除了混合注意力,GLM-5.3-Flash还引入了Manifold-Constrained Hyper-Connections,也就是mHC,用于提高模型扩展过程中的训练稳定性和参数利用效率。
这些改动共同指向一个目标:GLM-5.3-Flash不追求单纯把模型做得更大,而是希望减少完成同一任务所需的实际计算和存储资源。
亮点二:代码和Agent能力,是“牛来”的主要长板
从智谱公布的测试结果看,GLM-5.3-Flash的优势主要集中在代码、工具调用和长时间Agent任务上。
在DeepSWE v1.1中,GLM-5.3-Flash取得63.4分,高于GLM-5.2的46.2分。DeepSWE关注的并不是让模型补全一段代码,而是测试它能否进入真实代码仓库,理解项目结构、定位问题并完成修改。
在用于测试自动化操作能力的 AutomationBench 中,GLM-5.3-Flash 取得48.8分,GLM-5.2为26.2分。此外,它在 NL2Repo 上取得56.3分,在Toolathlon Verified上取得78.4分,在Agents’ Last Exam中取得26.3分,在Terminal-Bench 2.1中取得84.3分。
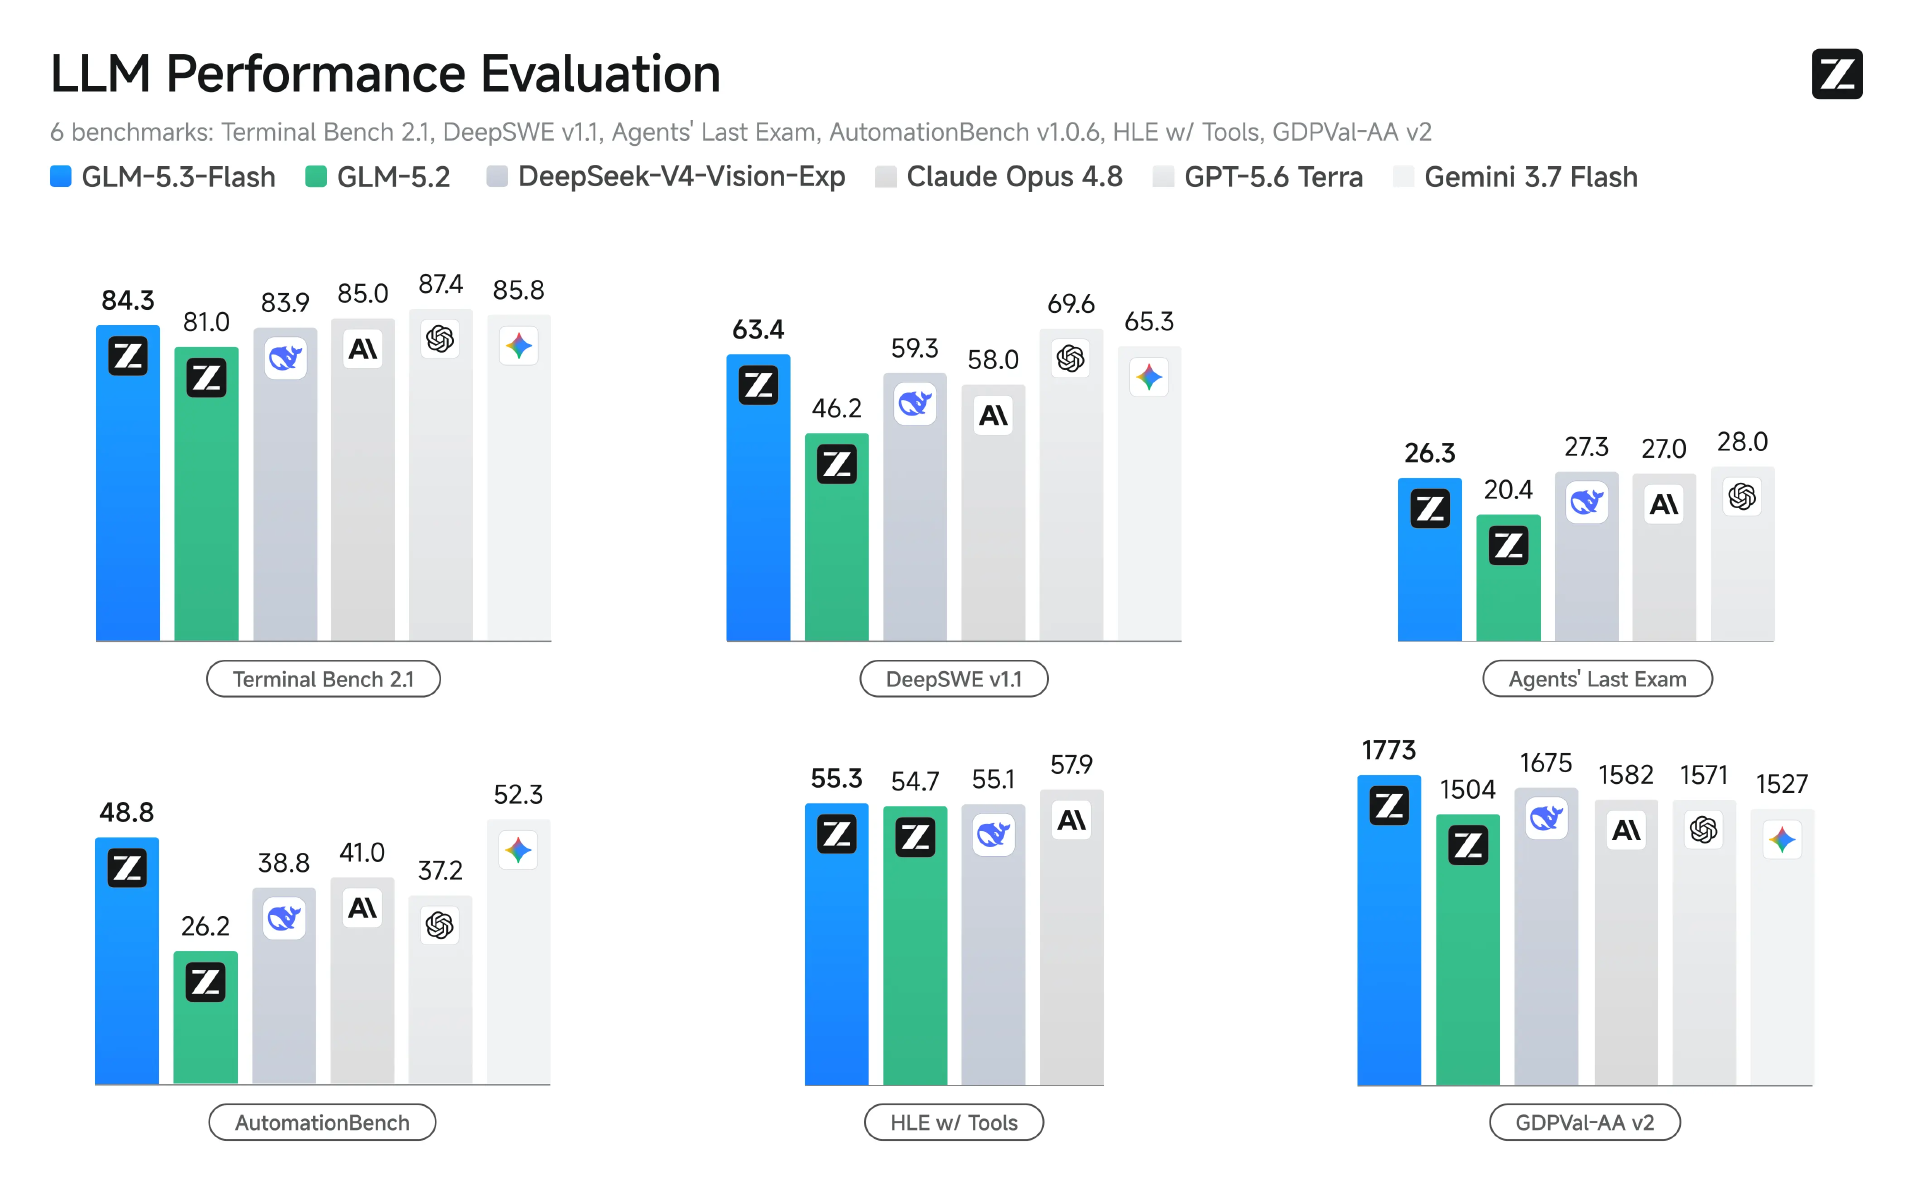
Terminal-Bench主要测试模型能否在真实终端环境中完成软件工程、系统管理和数据处理任务。模型不仅要给出答案,还要实际调用命令、观察执行结果、处理错误并继续推进任务。
这些测试更接近当前 Coding Agent 的工作方式:模型需要连续思考和操作,而不是一次性生成代码。
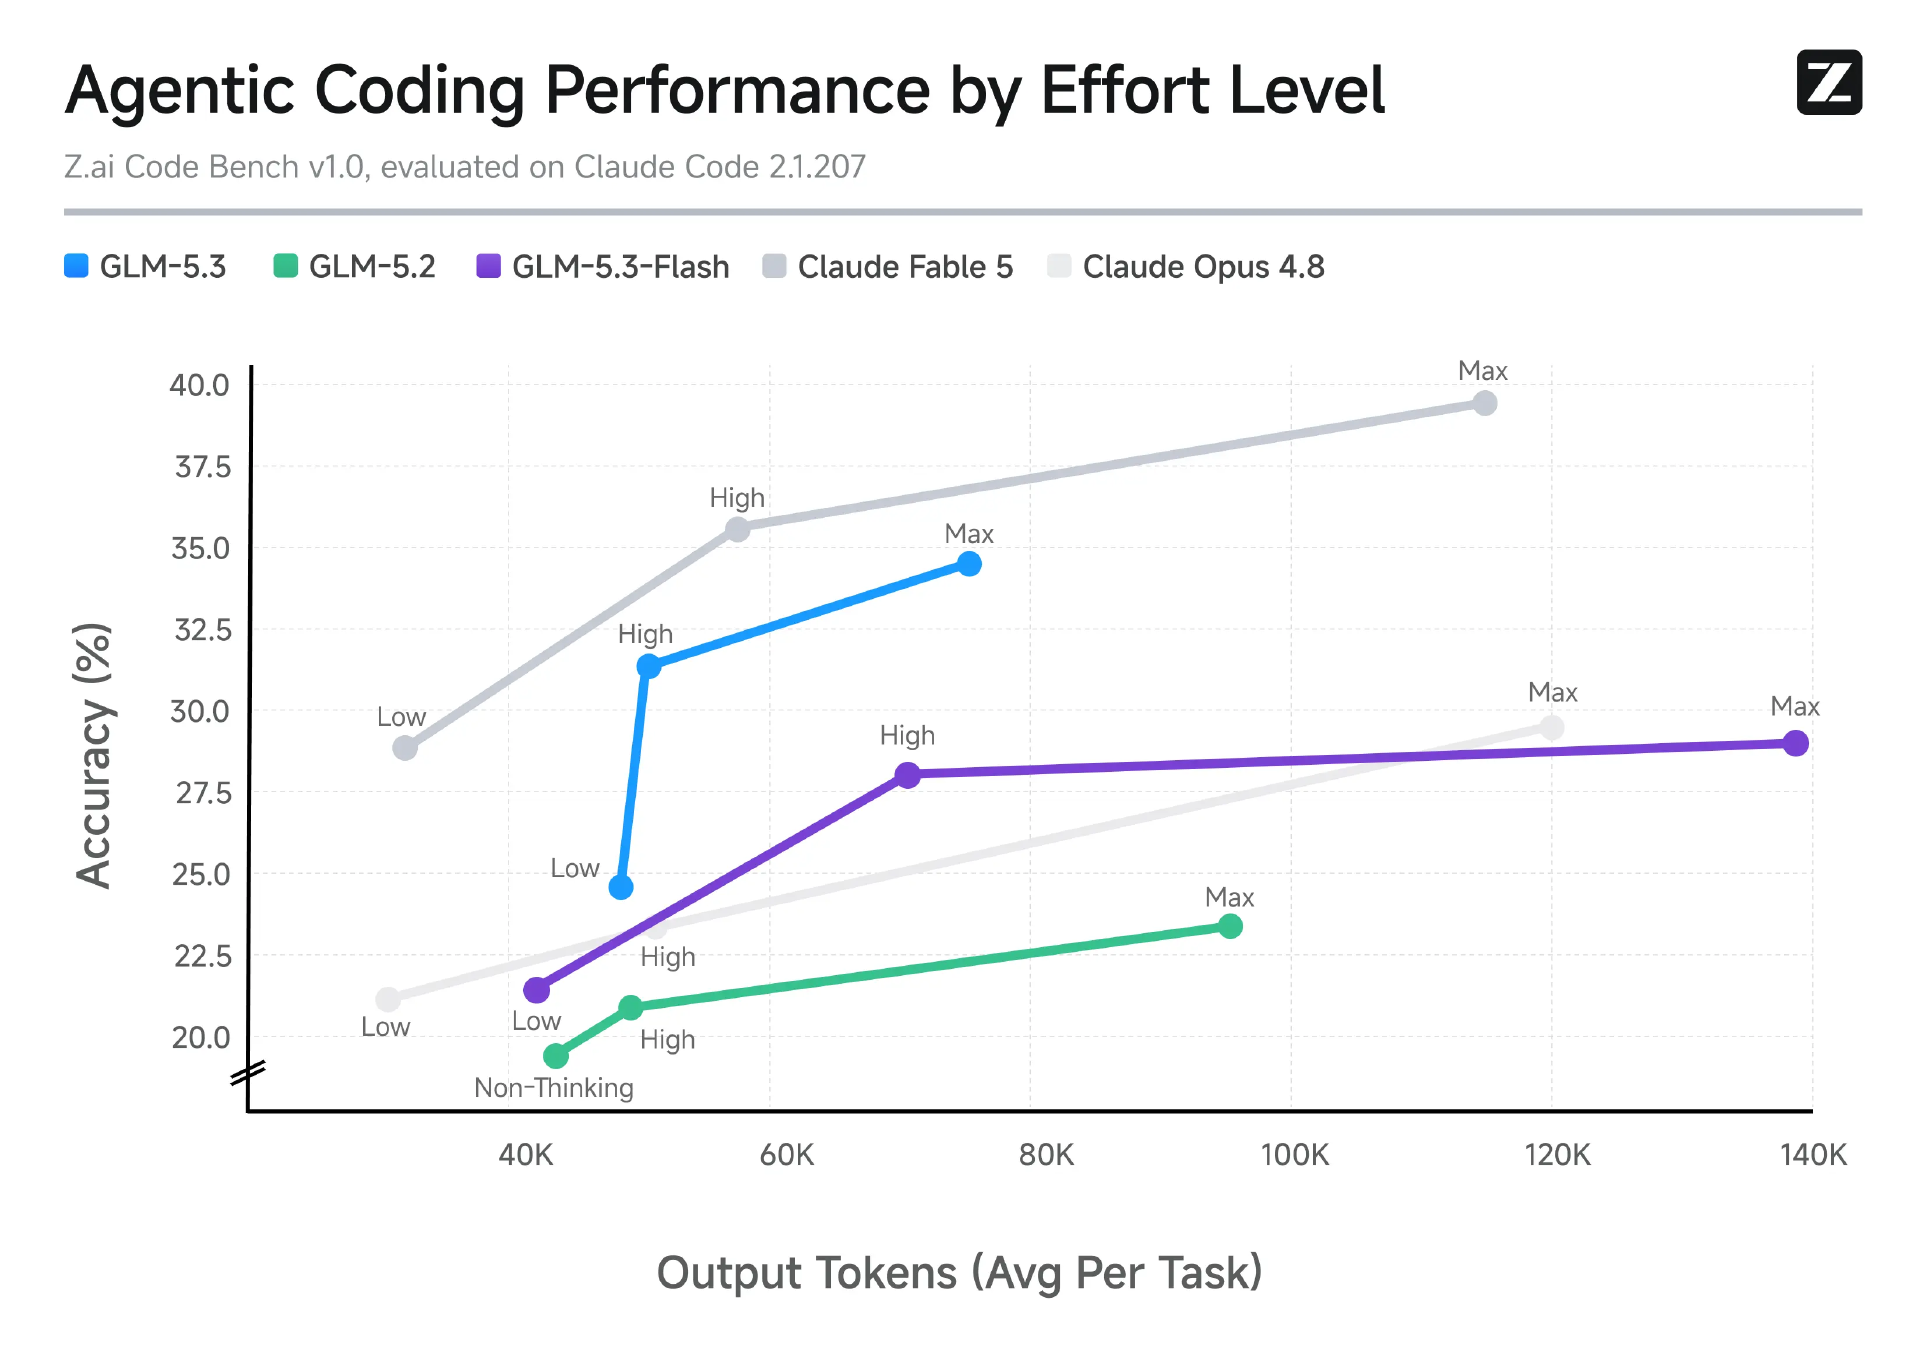
在智谱内部的Z.ai Code Bench v1.0测试中,GLM-5.3-Flash在不同推理强度下均超过GLM-5.2。在最高推理强度下,它取得29.0分,接近Claude Opus 4.8的29.5分。该测试运行在Claude Code 2.1.207环境中。
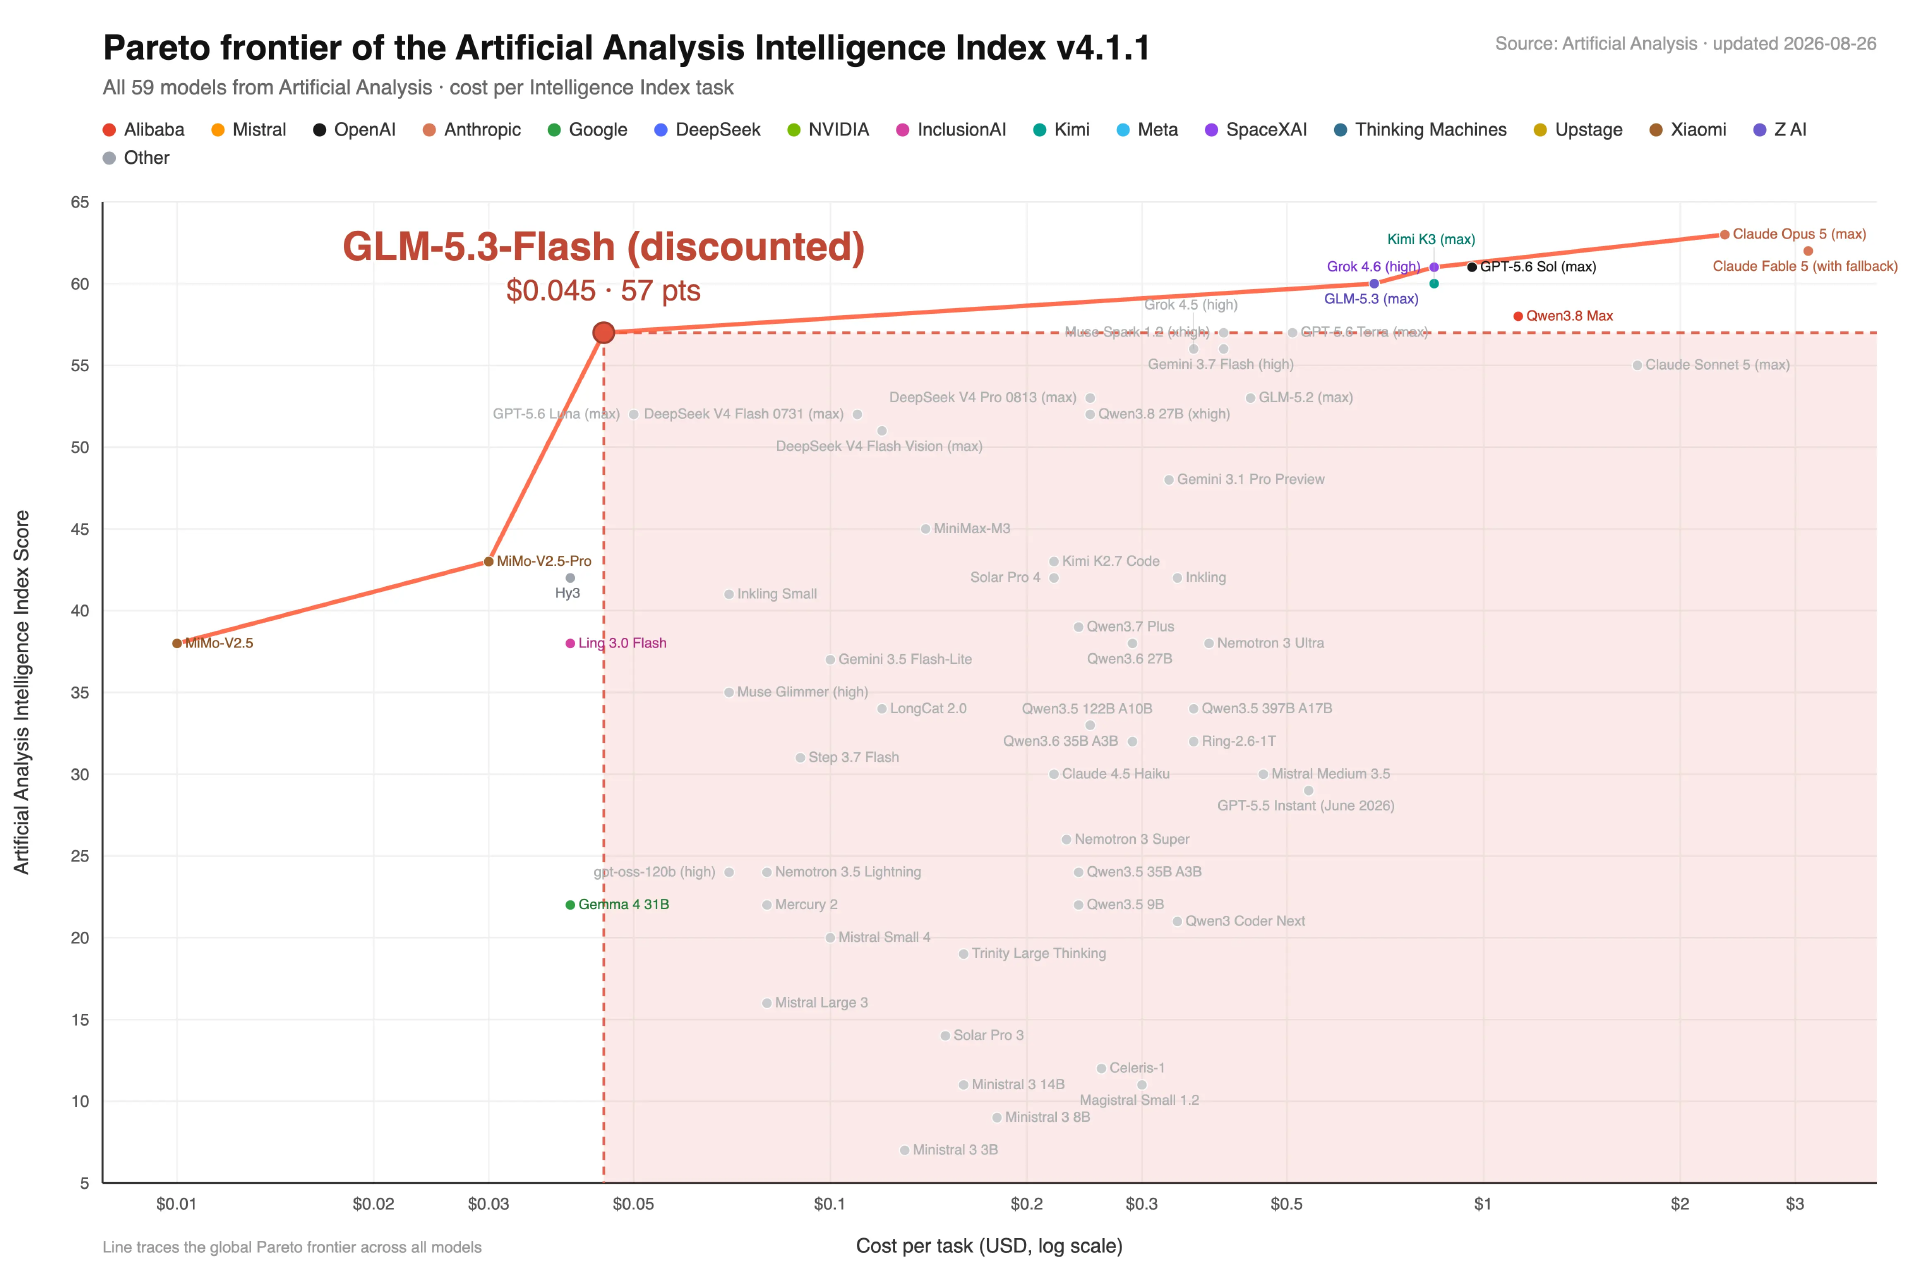
第三方机构 Artificial Analysis 则给GLM-5.3-Flash的综合智能指数打出57分。
在优惠价格口径下,其平均每项任务成本约为0.045美元。智谱称,过去大约需要十倍成本才能获得相近水平的综合表现。
不同代码和 Agent 模型采用的测试框架、工具环境、推理预算、最大输出长度和超时时间可能存在差异。例如,智谱在Terminal-Bench 2.1测试中允许模型最长运行6小时,并将最大生成长度设为65536 Token;DeepSWE同样采用6小时超时设置。
因此,基准测试能够说明模型在特定设置下具备较强的代码和Agent能力,却不能直接等同于所有真实生产任务中的表现。智谱内部的Z.ai Code Bench同样属于厂商自测,仍需要更多第三方复现。
Ox Alpha匿名测试的意义,恰恰在于补充了跑分之外的证据:在开发者不知道厂商和模型名称的情况下,它仍然依靠真实体验获得了较高关注度。
亮点三:视觉能力进入代码执行闭环
GLM-5.3-Flash的另一项变化,是不再把视觉理解视为独立的看图能力,而是将其放入代码和Agent 执行过程中。
传统代码模型生成网页、游戏或3D场景后,主要通过程序是否成功运行、测试是否通过来判断任务是否完成。但很多问题无法仅通过代码检查发现。
一个网页可能可以正常启动,按钮和颜色却与设计稿明显不符;一段Blender脚本可能成功运行,最终场景却存在模型穿插、比例错误或光照异常;一款游戏可能没有报错,却无法真正完成交互。
初始版本存在布局问题
视觉自我验证后
GLM-5.3-Flash 试图形成“观察—实现—使用—修正”的闭环:模型先读取截图、设计稿、页面录屏或者真实软件界面,生成代码并运行,再观察渲染结果,与参考画面进行比较,最后继续修改。
为此,智谱构建了面向视觉编码的数据合成流程,重点训练模型的自我视觉判断和测试时改进能力。在前端开发场景中,团队还引入环境反馈强化学习,并通过基于真实用户流程的Agent验证,提高模型对GUI界面和交互结果的判断能力。
这种能力可以覆盖前端页面复刻、游戏开发、Blender 3D场景、CAD建模以及Computer Use等任务。
国产芯片撑起了Ox Alpha的全部流量
GLM-5.3-Flash官方博客中另一个值得关注的信息,是Ox Alpha匿名测试期间的全部推理流量均运行在国产AI芯片集群上。
智谱称,为解决单颗国产芯片在计算能力和显存容量上的限制,团队基于SGLang为GLM-5.3-Flash开发了专用推理引擎。
其中包括多项针对模型架构和硬件特点的优化:线性注意力和LM Head采用节点内张量并行,引入ReplaySSM、W8A8量化、INT8/FP8/BF16混合KV Cache量化,以及Layer Split等方案。
在集群层面,智谱采用Encode—Prefill—Decode分离架构,将多模态编码、提示词预填充和逐Token解码拆分为可以独立调度和扩展的工作池。
这三个阶段的计算特征并不相同。图像和视频编码更依赖多模态计算,Prefill需要一次性处理大量输入Token,Decode则需要持续生成Token。将三者拆开后,系统可以分别分配硬件资源,避免不同负载互相等待。
按照智谱披露,这套系统已经运行在数万颗国产加速芯片之上。相较最初在同一硬件上的基线版本,端到端推理性能提高了3倍,每Token成本和硬件效率达到与主流英伟达 GPU 相当的水平。
实测:“牛马”友好
全网都在实测这款模型,小编也忍不住上手测了下。GLM-5.3-Flash 主打原生多模态、Coding、长上下文和 Agent 任务,所以我把这次测试的重点放在了“看懂—规划—执行—检查”的闭环能力上。
首先给模型出了一道测试题:有三个盒子,标签分别写着“苹果”“橘子”“苹果和橘子”,但三个标签全部贴错了。你只能从一个盒子里取出一个水果,如何确定三个盒子分别装了什么?先给答案,再用不超过150字解释。
GLM-5.3-Flash 耗时仅 13秒,消耗2303 token 就给出了答案,它答道:从标“苹果和橘子”的盒子取一个。
解释:因为三个标签全错,“苹果和橘子”标签下一定不是混合,只能是苹果或橘子。若取出苹果,则该盒是苹果;“橘子”标签不能装橘子,只能装混合;“苹果和橘子”标签装橘子。若取出橘子,则对称推出。
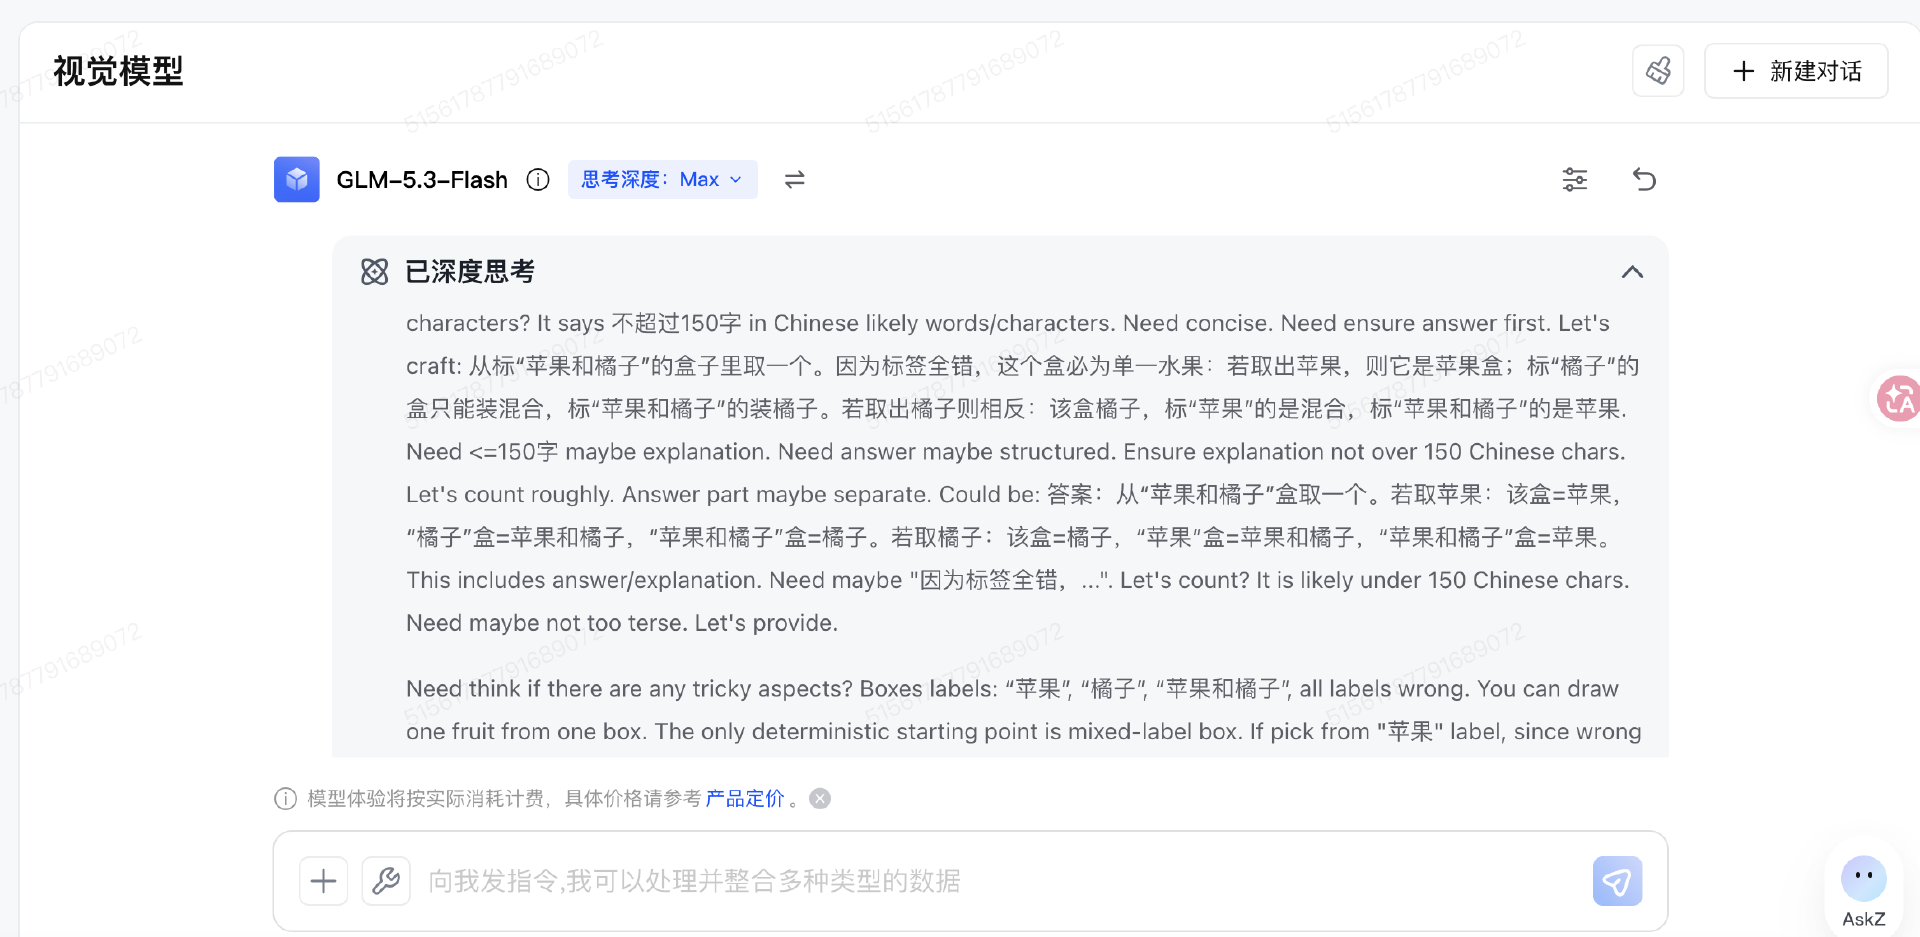
结果是正确的,符合推理逻辑。
第二道逻辑测试题的提示词是:我下周要去上海出差三天,需要参加两场会议、采访三家公司,并完成一篇2500字报道。请给出一个具体日程。要求每天工作不超过9小时;采访之间至少留出40分钟;第一天晚上不能写稿;第三天下午5点前交稿。请检查计划是否存在时间冲突。
模型给我制定的“上海出差三日日程方案”如下:
前提假设:第一天上午从出发地赴沪(高铁/航班约2.5小时);纯交通时间不计入工作时长;会议均为半天内的单个会议。
Day 1(周一日)—— 抵达 + 会议1 + 采访
当日工作时长:约4.2小时
但其实这里在时间规划上就出现了一些误差,因为还要算上从家或者公司出发通勤去机场或高铁站的时间。此外整个流程没有预留一些休整时间,这就有点......
Day 2(周二)—— 会议2 + 采访② + 初稿
当日工作时长:约7.8小时
Day 3(周三)—— 采访③ + 完稿提交
当日工作时长:约6小时
冲突检查结果
唯一风险点:Day 1 若航班/高铁晚点,会影响13:30的会议①。建议提前一晚(周日)抵沪入住,或选择8点前出发的早班交通。
整体来看,给出的日程规划比较合理,但在任务与任务的衔接上,还是要留出一些休整时间,排得过于紧凑难免让人感到疲惫。
此外,为了测试该模型的图片理解能力,正好昨晚 MiniMax 发布了半年度财报,小编直接截图给它,看看它的理解能力如何。
我的提示词是:请逐项提取图片中的模型名称、分数和排名,整理成表格。先忠实识别原始数据,再总结三个结论。看不清的数字标记为“无法确认”,不允许推测。
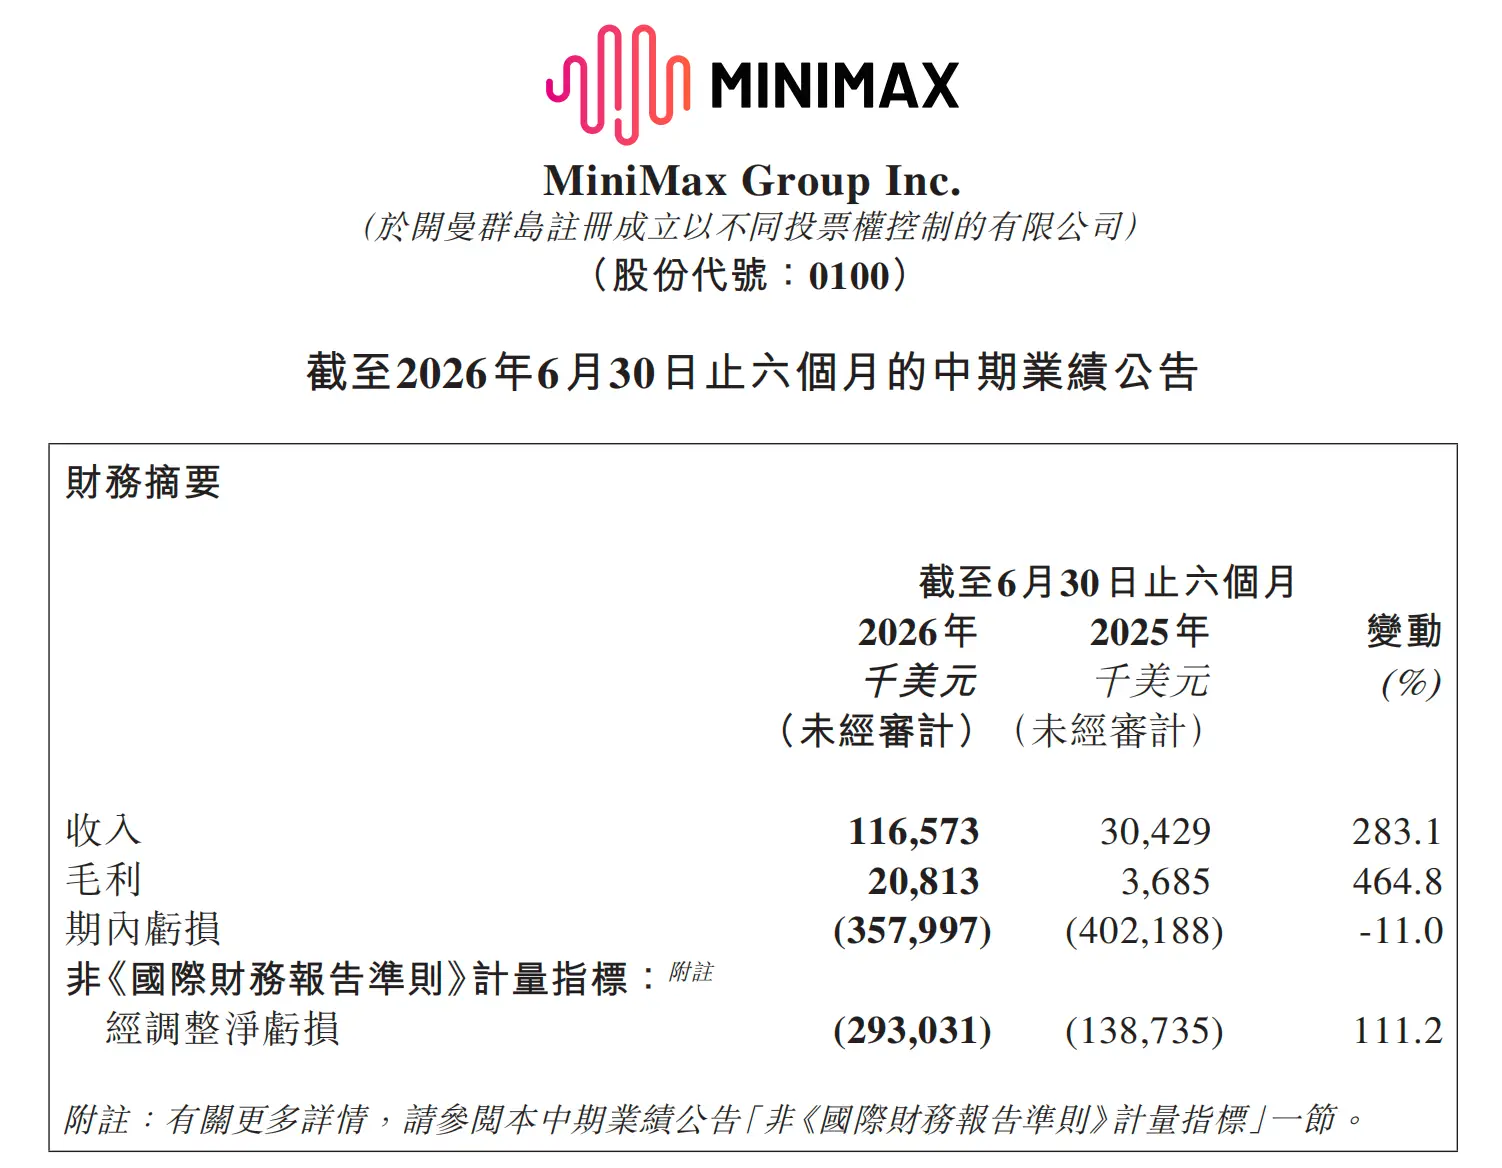
新模型基于图中实际数据,给出了三点结论:
收入高速增长:2026年上半年收入 1.17 亿美元,同比增长 283.1%,业务规模快速扩张。毛利率改善:毛利增速(+464.8%)远超收入增速;据此计算毛利率从约 12.1% 提升至约 17.9%(此为根据图中数字换算,非公告原文)。亏损结构分化:《国际财务报告准则》下期内亏损小幅收窄 11.0%,但经调整净亏损扩大 111.2%(约 2.93 亿美元),说明剔除相关项目后经营消耗反而在加大,盈利拐点尚未到来。
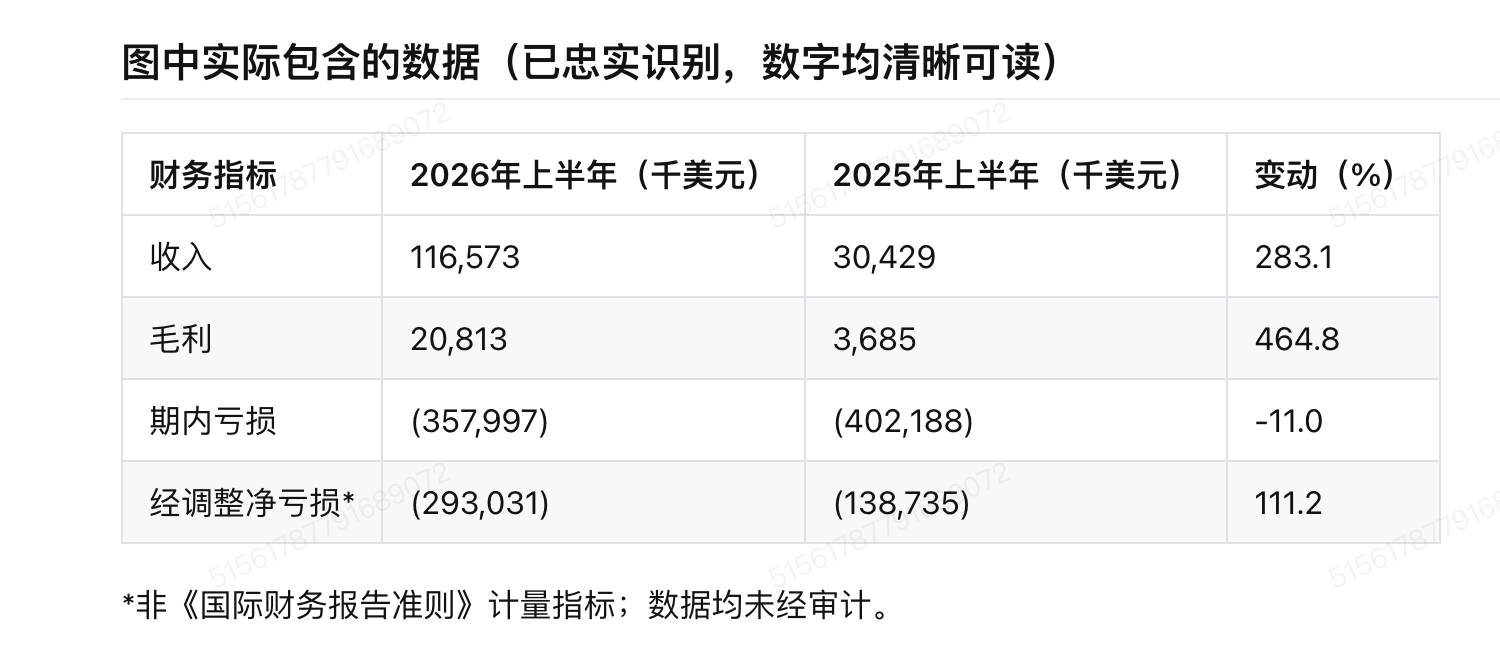
从结果来看,GLM-5.3-Flash 能够较准确地识别图片中的模型名称、排名和对应分数,并按照要求整理为结构化内容。图中数字均被完整提取,没有出现明显漏项、错位或将不同列数据混淆的情况。
新模型发布后,海外社区很快围绕其技术路线、免费策略和实际部署展开讨论。
网友 Aniket 略带遗憾地表示:“免费的 Ox Alpha 没有了。”这也从侧面反映出,此前以匿名形式开放测试的 Ox Alpha,可能已经积累了一批用户。
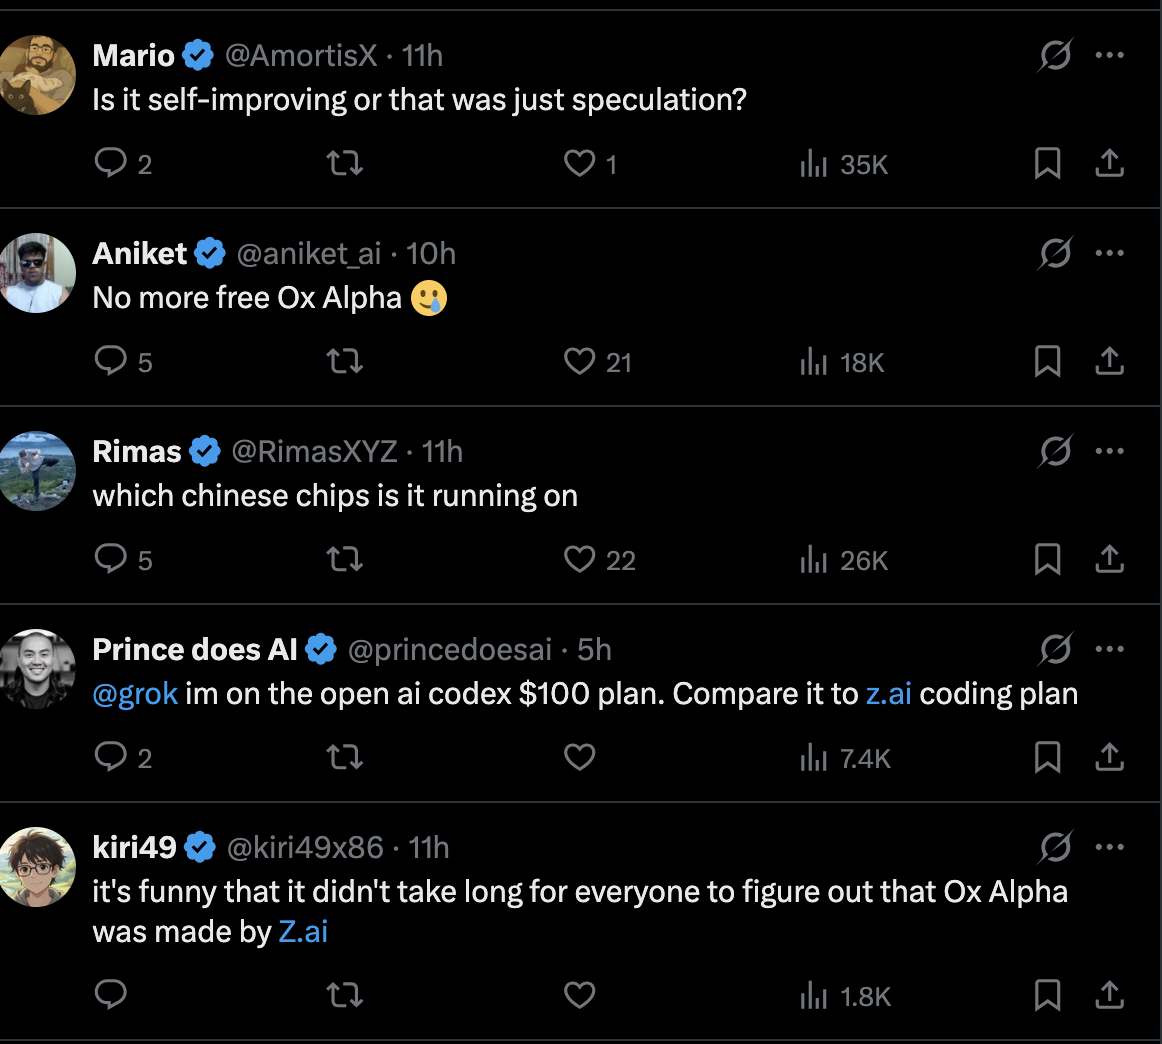
模型运行在哪类硬件上同样受到关注。Rimas 直接询问,它究竟运行在哪款中国芯片上。另有用户希望将 Z.ai Coding Plan 与每月100美元的 OpenAI Codex套餐进行比较,关注两者在编程能力、额度和成本上的实际差异。
此外,也有一些海外用户实测了该模型,一名x用户质疑模型处理长时间编程任务的可靠性,于是他连续消耗两个5小时额度周期测试该模型,但发现模型仍未能解决一个简单Bug,最终交付的有效结果也非常有限。
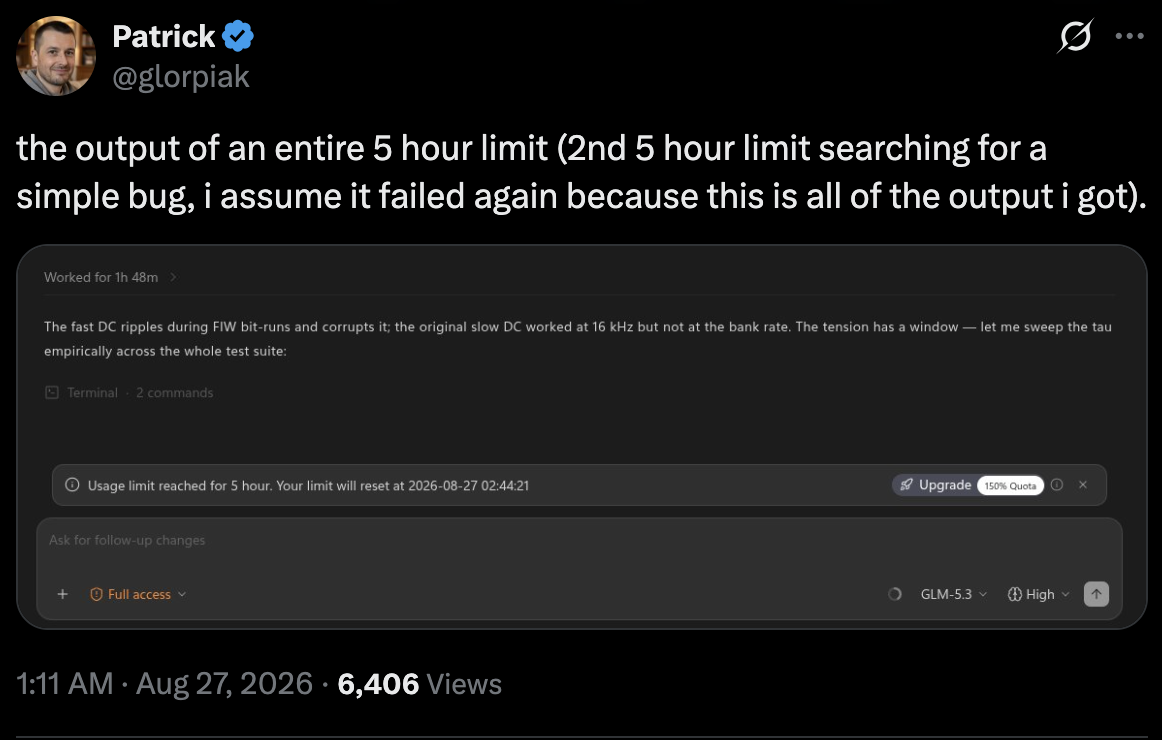
整体来看,海外用户的关注点已经不只停留在模型分数,而是进一步延伸至技术机制、底层芯片、价格和真实编程体验。
参考链接:
https://z.ai/blog/glm-5.3-flash"
https://techcrunch.com/2026/08/26/surprise-z-ai-is-the-ai-lab-behind-the-mysterious-ox-alpha-model/"
内容来自 InfoQ 推荐,版权归原作者所有。
阅读原文 ↗