
随机生成5位数,得到11111和得到54176的概率相同,为什么遇到前者时我们会觉得随机算法有问题?
恭喜你,你注意力惊人,注意到了网络安全中非常有意思的一个实战型密码学概念。
因为不用觉得随机算法有问题这个问题好像理论上很反直觉,而是确实生成了 11111111 123123123 这种数字的时候,这个随机算法确实有更大概率是有问题的(当然,因为算法已经出问题了,所以概率应该不会相同)。
先来一个简单易懂的概念:
如果设置一个 6 位数密码,你认为,设置“123456”和"259765"哪一个问题更大?
显然是前者,就是说如果随便给你一个人,让你必须猜他设置的密码是多少,那么前者出现的概率,明显会比后者大得多。
因此,如果在不考虑“人”的因素之下,一个“完美的随机数生成算法”,生成 11111 和 54176 的数学理论上是相等的,但是一旦加入“人”的因素,这个概率的天平就会出现严重的倾斜,因为基于“人”和“成本”的考虑下,我们很多时候很难设计一个完美的随机数生成算法,而一旦随机数生成算法(或者用法)出现了 bug,出现这种规律性数字的概率就会变得异常的大。
所以这个问题比较的并不是数学理论上的等价概念。
而是:当一个随机算法(代码)仅看其单测试情况下,它生成了一个非常有规律数字,这个算法存在 bug 的概率,是否比它不存在 bug 的概率更大。当我们换了一种问法,那答案就非常显而易见了。
当然,实际使用中,很多时候这个 bug 并不会那么的明显
举一个非常著名的例子,下面是一个非常简单(且常用)的线性同余随机数发生算法。
unsigned int rand(void) {
    seed = seed * 1103515245 + 12345;
    return seed;
}
但如果我不说,你不问,那么估计很多人没有意识到。线性同余随机数的低位随机性是由严重缺陷的。也就是说比如你用奇偶性对其生成的随机数进行测试,你马上就会发现这个算法在使用上的严重问题,尽管奇数偶数出现概率大概会趋于 50%,
但是低位会出现奇偶数交替出现的问题,比如 01010101010101......
不过不用觉得灰心,理论理解和工程落地出现严重偏差的情况,即使是大神也会翻车。
最著名的例子,估计就是那个强制要求你密码中一定要用至少一个大写字母和其它字母和数字之外的特殊字符的深坑标准了(就是当年的下面这份)
参与这份标准制定的,是 William E. Burr,曾在美国国家标准与技术研究院 NIST 工作。因为早期很多“密码必须大小写、数字、特殊符号混合,并且定期更换”的规则,大约在 2003 年,NIST 发布了密码相关指南。当时推荐过类似这些做法:密码要包含大写字母,小写字母,数字,特殊符号,密码复杂度越高越安全。于是很多公司、学校、政府系统都开始要求这种密码:
P@ssw0rd!2026,理论上看,确实不错,因为明显密码的熵提高了。
但是在实际使用中,发现成了一个上有政策下有对策的坑爹结果,几乎大部分人都是让第一个字母大写,或者在结尾加一个感叹号,要不然就是把 a 换成@,结果就出现了一堆这种“看似熵更高,但实际上并没有什么卵用,只是让人更难记住的密码”,对密码强度几乎没什么实际性影响。甚至很多用户为了记住密码。反而把做出密码写在纸上、存在不安全的文档里、多个网站共用同一个密码、使用很有规律的变体,密码强度反而降低了。
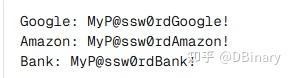
所以在最新的 800-63B 中,删除了这部分建议。
但是哪怕在今天,仍然有一堆三脚猫的产品和程序在用这种过时的密码设置标准。
所以,为什么我一直说工程开发一定要接地气接地气接地气,别整天活在象牙塔里,别光学理论,学完一定要实践要落地要调查,别光靠脑子里梦游就把鼻子就抬上天了。以上。
内容来自 知乎日报,版权归原作者所有。
阅读原文 ↗