
Netflix详述如何扩展其实时服务地图
Netflix在一篇技术博客文章"中介绍了如何重新设计驱动Service Topology的流式处理管道,以支持其生产规模。该系统现采用三阶段结构,将中间解析过程与丰富和持久化过程实现了分离,将回压传播回Kafka而不是丢弃记录,并在高流量内部传输时使用服务器发送事件(server-sent event)来取代gRPC。
该说明延续了Netflix此前对Service Topology多源图"的介绍,侧重于在规模化环境下保持网络流管道处于最新状态所需的生产工程实践。
Service Topology结合了来自eBPF"网络流、进程间通信(IPC)指标和分布式追踪"的独立存储视图。工程师可以独立查询各层,也可以进行合并以获得更广泛的服务依赖视图。Netflix表示,团队将其用于事故调查、影响范围分析、依赖关系理解和生产变更管理。
新文章聚焦网络流的摄取路径。原始流记录反映的是网络跳转(hop)而非逻辑上的应用依赖:流量可能经过负载均衡、NAT网关、API网关或代理。因此,Netflix将数据处理分为三个阶段。第一阶段消费多区域的Kafka"流,过滤无效记录,将数据按五分钟的窗口进行批处理,并创建初始聚合器。第二阶段将中间跳转解析为直接的应用到应用的边,并重新分发这些结果。最后阶段在持久化到图数据库之前,为节点添加健康、归属和元数据等信息以完成数据丰富的过程。
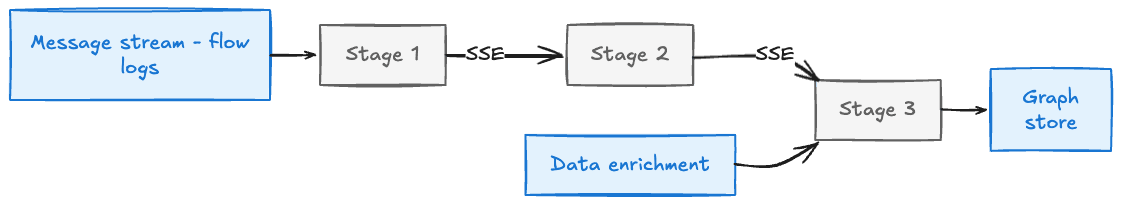
Netflix将初始聚合、中间解析和图持久化分为三阶段。(来源")
Netflix表示,早期设计会将工作集中到热门目标上。由于中间解析需要将相关流汇聚在一起,热门目标及其中间跳转可能导致实例变成“热点”。公司报告称,一些实例在执行I/O密集的数据丰富操作时,其流量可达到典型值的100倍。将解析过程与丰富和持久化过程实现分离,能够使系统能够重新分配这些负载。
该管道使用Apache Pekko Streams"来管理回压。Netflix表示,当图存储跟不上节奏时,压力会沿处理阶段向上游传播,直到Kafka消费者暂停,从而将记录保留在Kafka中,等待容量恢复。其后果是在高负载下出现新鲜度的延迟,而不是丢失数据或生成不完整的地图。Netflix认为这比在事故期间生成已过时的批量地图更可取。

当图写入变慢时,需求信号沿管道向上游传播到消息流。(来源")
Netflix还将管道阶段之间的gRPC"替换为服务器发送事件(SSE)"。公司报告称,在其规模下,序列化、连接池管理和流式响应的内存压力代价很高,因此将SSE描述为更轻量的方案并且能够兼容反应式回压。这里的内部传输与暴露给Service Topology客户端的gRPC API是分离的。
Netflix的处理集群会随需求伸缩。每个实例从服务注册表读取相同的健康实例列表,然后使用一致性哈希(consistent hashing)"决定哪个实例拥有每个聚合器。当实例加入或离开时,更新后的列表仅自动将受影响的聚合器移动到新所有者,而无需单独的重平衡过程。
IPC管道则不需要额外的重新分配步骤,它们的指标已经描述了应用级调用,并且从一开始就会按应用分区,使其能够在单个阶段中完成聚合。
文章还描述了历史重建过程。Service Topology并不保留完整的图快照或重放事件日志,而是保留按时间窗口的聚合器快照和属性级的变更历史。Netflix表示,可以在指定时间点重建拓扑,从而让工程师在事故前后检查依赖关系的变化。
内容来自 InfoQ 推荐,版权归原作者所有。
阅读原文 ↗