
开源大模型,很难再纯粹了
从自由开源软件到受控开放权重,头部大模型的协议已经分成两队。DeepSeek 守着 MIT,腾讯 Hy4、Qwen、Kimi 各自设了 MaaS 授权线、品牌露出和蒸馏条款,商业化落地前值得逐条读完。
WorkBuddy 绝配大模型,Hy4 正式版实测!超预期了
WorkBuddy 上免费用 Hy4 flash,推荐我的 2 个邪修玩法!
刚刚,继开源 Hy4 flash 之后,腾讯开源了 Hy4,权重文件 1.5 T,本地部署是与我无关了
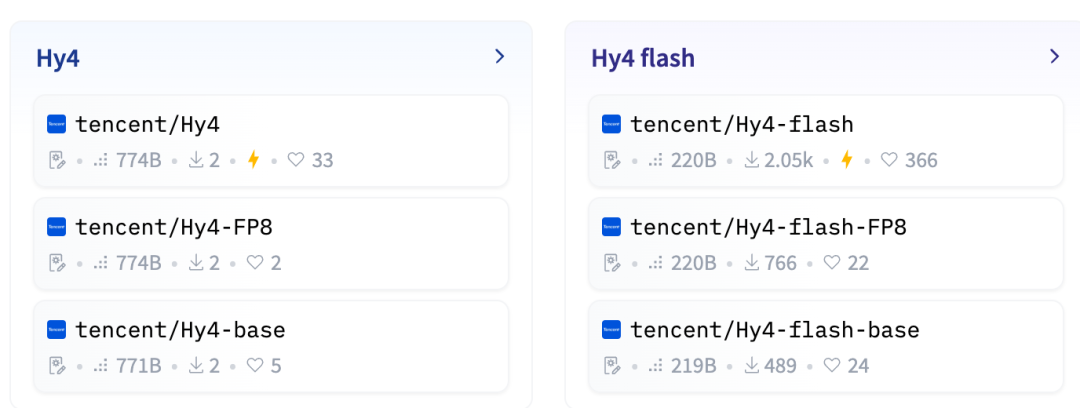
除了模型技术博客,我一般都会看一眼开源协议怎么写的
开源大模型的规则,很早就开始有变化了,我记得最早应该是 Kimi 吧
我梳理了一下 DeepSeek V4.1、阿里开源的主力 Qwen 3.8、以及月之暗面的 Kimi K3.1,LICENSE 内里的法律契约和商业约束已经彻底走向了两条截然不同的岔路
如果你打算拿开源大模型搞商业化、做企业私有化、搭 Agent、甚至包装成 API 卖给客户,一不留神踩中巨头设立的法务红线,后续可能就麻烦了
为什么说“开源大模型”很难再纯粹了
训练一个顶级基座模型,需要多少张 H100/H800?电费、集群互联、千人工程团队,一次全量预训练的硬成本是以亿为单位计算的
早年开源社区的浪漫主义,讲究的是无条件馈赠,遵从开放源代码促进会(OSI)定义的自由软件精神:代码和权重给你,你想怎么改就怎么改,你想怎么卖就怎么卖
但商业现实是:大厂砸了真金白银把权重放出来,转头就被某些第三方算力平台或 API 聚合服务商直接拉起镜像,挂上自己的计费系统按 Token 转手倒卖,一分钱研发成本不掏,坐收过路费
更夸张的是,某些团队拿这些顶级开源模型生成海量数据,去“蒸馏”自家的轻量模型,然后大肆宣传“全自研”,甚至回头跟开源母体抢客户
地主家里也没有余粮,模型厂商终于坐不住了
绝大多数模型已经由标准的“自由开源软件”,演进为了带有强防御属性的“受控开放权重”
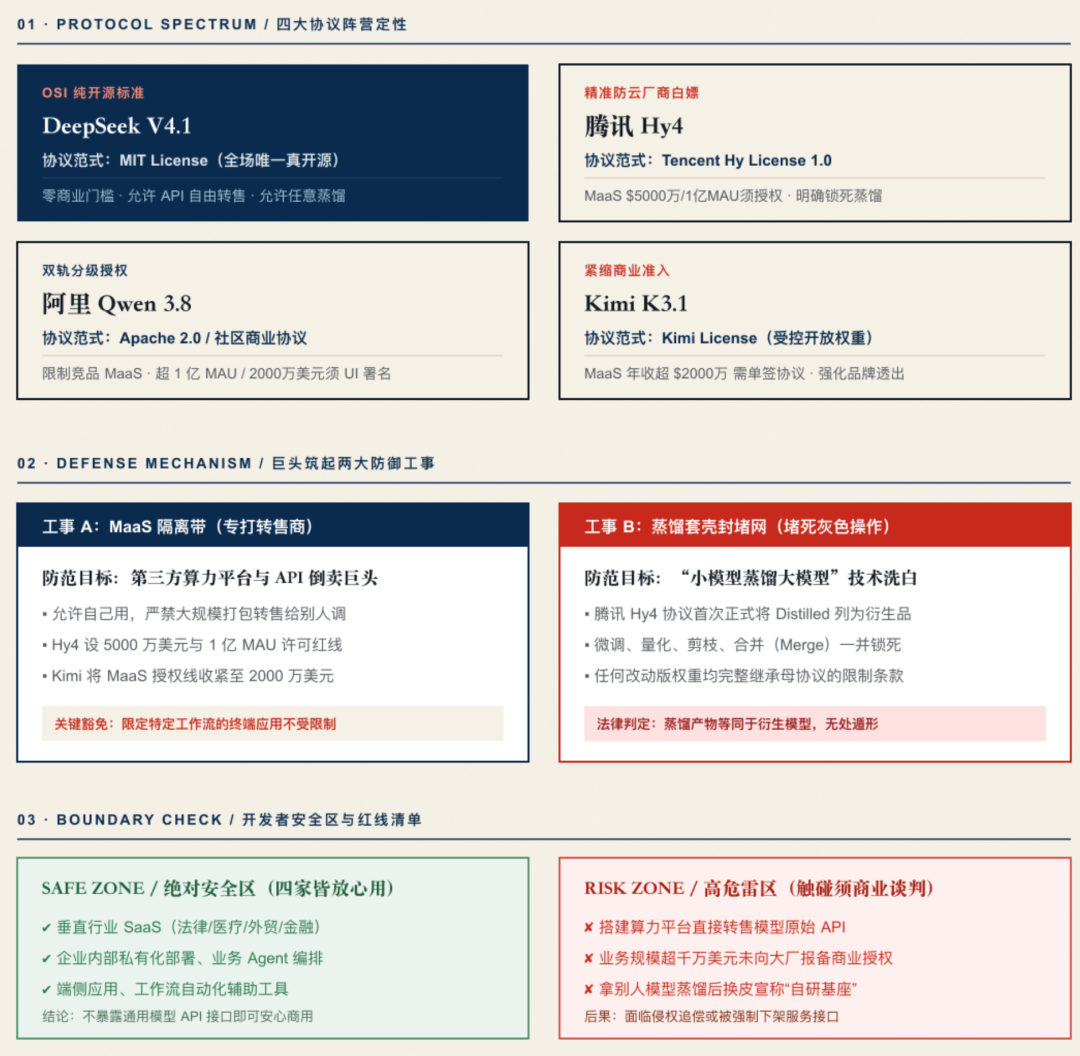
4 大头部协议全景拆解:谁真开放,谁设防线
1. DeepSeek V4.1:全场唯一的纯正孤勇者
DeepSeek 依然走了一条让整个硅谷和国内大厂都感到震撼的路线
DeepSeek V4.1 依然是标准的 MIT License
MIT 协议意味着什么?全球开源界最宽松的协议,没有之一:
- 零商业门槛:不管你公司年收入是 100 万还是 100 亿美元,完全免费商用
- 零用户量门槛:哪怕你的 App 拥有 5 亿月活,也不需要找 DeepSeek 报备
- 允许自由转售:云厂商直接拿去包装成商业 API 卖给客户,合规上毫无障碍
- 允许任意蒸馏:拿它的输出训练竞品模型,法律上挑不出任何毛病
唯一的合规义务,就是在代码和衍生发布物里保留一份原始的版权声明,仅此而已
2. 腾讯 Hy4:基于 Apache 2.0 深度定制的 Hy License 1.0
腾讯在 Hy4 上的做法非常聪明,也很代表当下互联网大厂的标准态度
它使用的不是标准的 Apache 2.0,而是一份名为 Tencent Hy License, Version 1.0 的派生协议,杀手锏集中在第 10 条的“附加商业条款”:
- 精准狙击 MaaS:协议明确界定了什么是模型即服务(MaaS),即允许第三方远程调用推理或微调接口
- 双重硬性授权红线:只要你运营 MaaS 业务,并且满足“连续 12 个月全球总营收超过 5000 万美元”或“月活跃用户(MAU)超过 1 亿”,就必须单独向腾讯发邮件申请书面商业许可
- 垂直应用保护机制:腾讯非常体贴地在 10.1 条款中明确排除了“将模型能力限定在特定业务功能或工作流中的终端用户产品”,做具体场景的垂直应用可以赦免
- 封堵蒸馏漏洞:把微调、量化、剪枝、合并、以及“蒸馏(Distilled)”划进了衍生作品范畴
3. 阿里 Qwen 3.8:双轨分级制
通义千问系列目前采取的是非常成熟的分级防御策略:
- 小尺寸的 Dense 基础模型,部分依然保留宽松的 Apache 2.0 协议
- 真正能打的 MoE 旗舰与 Flash 版本,全面采用 Qwen Community License(社区商业协议)
- 限制竞品与直接 MaaS:限制把模型包装成同类型的模型即服务或 AI 助理进行同质化竞争
- 规模与曝光门槛:月活超过 1 亿或月营收超过 2000 万美元的企业,必须向阿里报备商业许可,且必须在客户端用户界面显著标注 Qwen 品牌
4. 月之暗面 Kimi K3.1:紧缩型准入
Kimi 的开放权重协议进一步收紧了对第三方商业平台的门槛:
- 更低的 MaaS 触发线:将 MaaS 运营商的单独授权门槛直接压到了连续 12 个月累计营收超过 2000 万美元
- 强行绑定品牌透出:一旦产品达到大型商业规模,要求客户端必须强制显式露出 “Powered by Kimi K3.1” 字样
- 衍生模型必须完整继承相同条款,严防套壳洗白
协议横向对比表
为了让大家看得更直观,老章把这四家主流模型的关键法律维度整理成了一张横评表:
| 评估维度 | DeepSeek V4.1 | 腾讯 Hy4 | 阿里 Qwen 3.8 | 月之暗面 Kimi K3.1 |
|---|---|---|---|---|
| 基础协议范式 | 标准 MIT License | Tencent Hy License 1.0 | Apache 2.0 / 社区双轨制 | Kimi License |
| OSI 自由开源认证 | 完全符合 | 否(受控开放权重) | 仅基础版符合 | 否(受控开放权重) |
| MaaS 免授权上限 | 无限额度 | 营收超 $50M 或 MAU 超 1 亿须单独申请 | 限制竞品 MaaS / 须申请商业许可 | 12 个月累计超 $20M 须单独签约 |
| 垂直应用豁免 | 完全自由 | 条款明确明文豁免 | 一般垂直场景豁免 | 一般垂直场景豁免 |
| 蒸馏模型(Distilled) | 允许无限制蒸馏 | 正式列为衍生作品管理 | 纳入社区协议约束 | 纳入衍生协议约束 |
| UI 强制署名义务 | 无(仅保留文本声明) | 无强制 UI 署名 | 超 1 亿 MAU / $20M 月收强制署名 | 超大规模商业化强制透出 |
两个致命暗礁:蒸馏洗白与第三方 MaaS
仔细拆解腾讯 Hy4 与 Qwen、Kimi 的最新协议,你会发现大厂法务团队在 2026 年重点堵住了过去两年的两个最大漏洞:
暗礁一:蒸馏(Distillation)的法律灰产彻底终结
过去两年技术圈心照不宣的操作是:大模型协议禁止商用?没关系,我拿你 70B/120B 的开源大模型跑出几十万条高质量对话样本,拿这些合成数据去微调一个我自己的 7B 小模型,然后对外宣称拥有“完全自主知识产权”
但在腾讯 Hy4 的定义条款里,明确写道:
“Derivative Works include any fine-tuned, quantized, distilled, merged, pruned, or otherwise modified versions of the model weights.”
微调、量化、剪枝、合并、以及蒸馏,全部被定义为“衍生作品”
这意味着,只要你使用了 Hy4 的权重或输出蒸馏出新模型,这个新模型在法律层面上依然是 Hy4 的衍生品,必须受制于 Hy4 的许可证约束,一旦你的平台流水或用户规模达到阈值,同样属于违规侵权
这一招直接把国内靠蒸馏做套壳模型的所谓“自研团队”逼到了墙角
暗礁二:筑高墙,防止第三方云厂商“无偿转售截流”
大厂并不反对企业把模型集成进自己的业务,大厂真正痛恨的是“二手贩子”
无论是腾讯云、阿里云还是火山引擎,大家都有自己的算力云平台和模型 API 业务,如果自家辛辛苦苦研发并开源的模型,被竞争对手或其他算力平台直接拿去按每百万 Token 几分钱转售,不仅抢走了开发者流量,还直接掏空了大厂的 MaaS 商业基本盘
Hy4 的 5000 万美元红线、Kimi 的 2000 万美元红线、Qwen 的竞品防御条款,本质上全是在云基础设施层面画下的“停火线”
谁该放心用,谁该提心吊胆
那我们到底还能不能用这些开源模型?其实多数不需要担心,只要你的产品不向第三方提供直接的、通用的模型 API 接口,只把模型作为后台工作流的一个执行单元,你就在免责安全区
1. 绝对安全区(四家皆可放心大胆用)
- 垂直领域的特定 SaaS(如外贸邮件生成、法律文书初筛、医疗辅助问答)
- 企业内部知识库、内网私有化问答机器人
- 个人独立开发者的效率小工具、特定工作流 Agent
2. 高危警惕区
- 打造自己的聚合 API 平台、按 Token 计费对外兜售推理服务的算力中间商
- 打算拿开源大模型蒸馏出小模型并申请商业贷款、政府项目或转售的团队
- 月活即将冲击数千万乃至过亿级别的通用 AI 助手产品,这一条我希望大家都能早日可以触发
总结
大模型领域没有永动机,也没有取之不尽的免费算力
DeepSeek 传闻也要上市了,后面还能不能继续纯粹?
作者:Ai学习的老章 公众号:Ai学习的老章
本文由 @Ai学习的老章 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议
内容来自 人人都是产品经理,版权归原作者所有。
阅读原文 ↗