
谷歌的 Gemini 4 Neon,综合能力到底强不强?
Neon和Carbon在AA同开high档都拿60分,Neon平均15分钟交卷,Carbon要34分钟;GDP.pdf读图33.4%反超旗舰。分数打平、时间减半的中间档,真能接住日常那些急活吗?
今天打开信息流和几个技术群,基本全被谷歌这个新模型给刷屏了,我也顺手翻了一圈各路评测。
说实话,我一直觉得谷歌的模型将来肯定不会弱于 OpenAI 或者 Claude。
尤其是之前看完《阿尔法 Go》那部纪录片之后如果只让推荐一个 AI 产品,镜哥的答案…,我就对 DeepMind 这帮人的底层研发功底始终很有信心——哪怕前两年节奏慢过半拍,我也总觉得它迟早能重回王座。
现在看谷歌这波密集出牌,确实越来越有那个味儿了。
他们甚至真把元素周期表搬来给模型起名:前脚刚铺开 Hydrogen(氢)、Carbon(碳)和 Argon(氩),美国时间 11 月 18 日,Gemini 4 家族又多了一个新名字——Neon(氖)。
目前已经开始向 Gemini App 的 Google AI Pro 和 Ultra 用户分批推送。
Google|Gemini 4 Neon 发布主视觉
于是,镜哥到处看评测,也是际体验了一番,说实话,刷完这轮评测,最先让惊讶的速度,尤其是它和自家旗舰 Carbon 的速度对比。
第三方评测机构 Artificial Analysis(下面简称 AA)把 Neon 和 Carbon 都开到 high 档,俩模型跑出了完全一样的 60 分。
但按这套评测折算下来,Neon 平均每项任务大概花 15 分钟,Carbon 得跑 34 分钟。
分数相同,时间直接省了一半多。
另外,额,如果把这几个化学元素按干活场景排一下,谷歌的分工就非常直白了:Hydrogen 接零碎快活,Carbon 扛最费脑子的长任务,从 Carbon 衍生出来的 Neon 刚好卡在中间。
说白了,桌上一堆文档、图表,下班前急着交一版像样的东西,这种活拿 Neon 来做其实非常爽,我特意试了下文档创作,真的比 GPT-6.2 的天书好太多太多了。
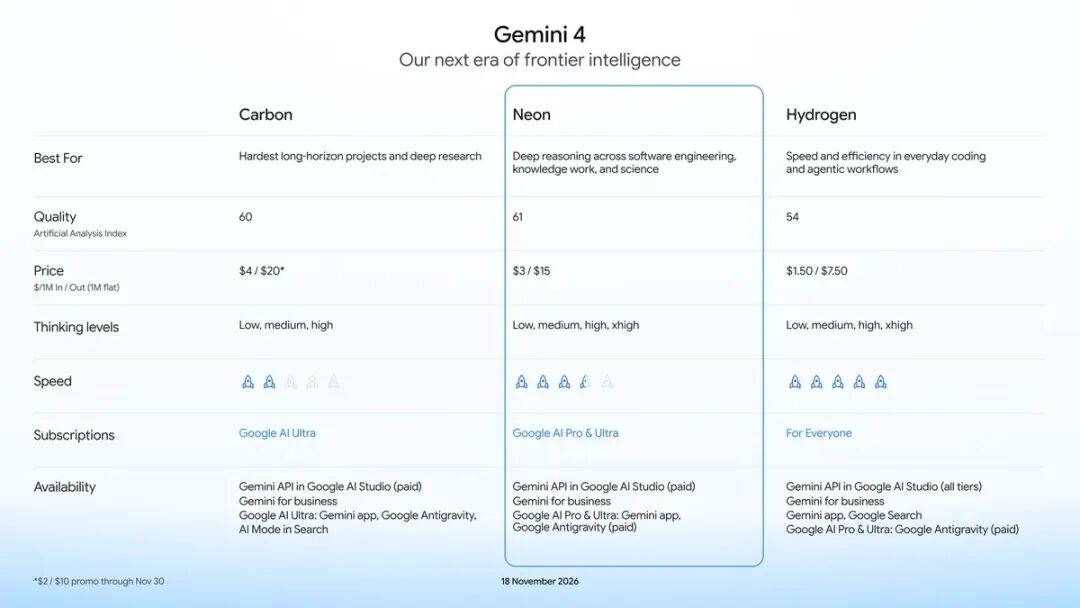
Google|Gemini 4 三款模型定位与入口
不过,少等那 19 分钟只能说明它交卷快。真落到日常干活,其实大家归根到底还是会更在意交出来的初稿,尤其是减少手动修改的频次。
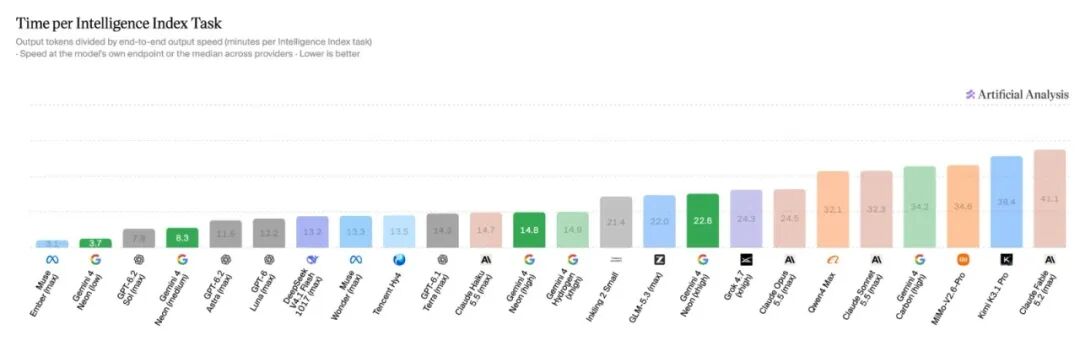
AA|Neon 与 Carbon 任务用时对比
往细了看几个硬核场景,就能感觉到谷歌这次不是在凑数,而是冲着真实工作流去的,要不怎么能联手 OpenAI 阻击即将上市的 A\呢。。。
另外。AA 有项专门考读 PDF 图表、表格和复杂版面的测试叫 GDP.pdf,Neon 在 high 档拿了 33.4%,直接反超了同档的 Carbon(28.4%)。
有意思的是,把 Neon 硬拉到最高的 xhigh 档,这项成绩反而掉到了 28.0%。
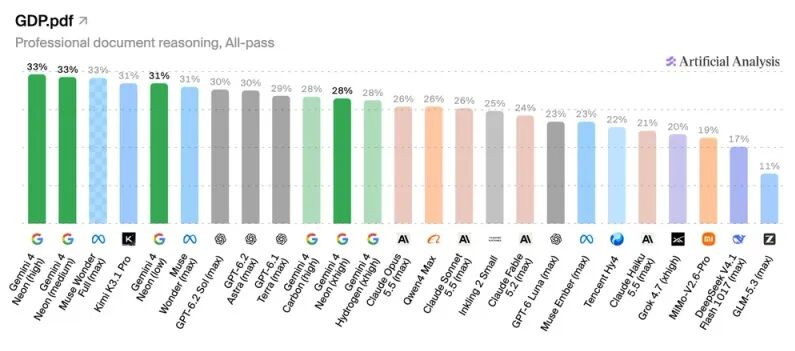
AA|GDP.pdf 读图与版面评测
AA 还拿同一道题让几个模型做演示稿。
看 Neon 交出来的那页,核心指标摆得很显眼,旁边顺手配了趋势和说明,扫一眼就知道想讲什么。
至少在搭框架和提炼重点上,不用从零改起,剩下的主要是核对口径——老板追问数字怎么算的,得能顺着这页找回原表。
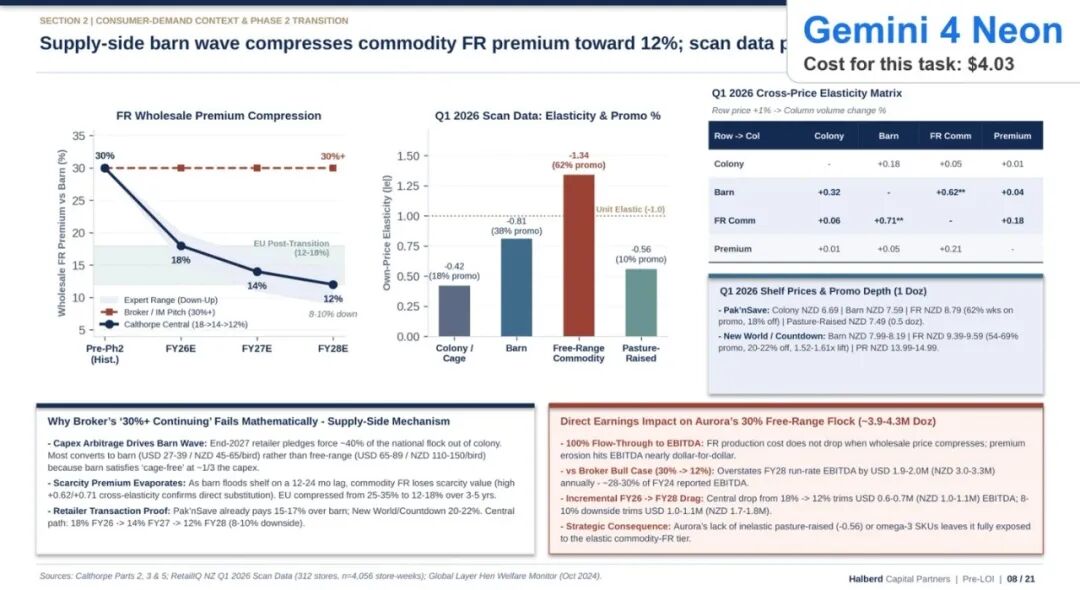
AA|Neon 演示稿生成样张
真正让我觉得“嗯,还是当年那个搞出 AlphaGo 的硬核团队”的,是谷歌官方放出来的几个实测案例。
比如在 Antigravity 里,Neon 把一张照片拆成色块,用了大约十万个单元格和超过五十万条公式,硬生生在表格里把照片拼了回来,而且每一格背后都是能重新计算的活公式。
你就说,这种场景是不是碉堡了吧?!至少从产品宣传角度,一般人想不出来这种冲击力的测试场景吧。。
表面看像在炫技,但背后拼的是超长链路下逻辑不断裂的工程功底——换到平时自己搭业务表,下个月填进一批新数,能保证这么复杂的公式链不算崩,才是真本事。
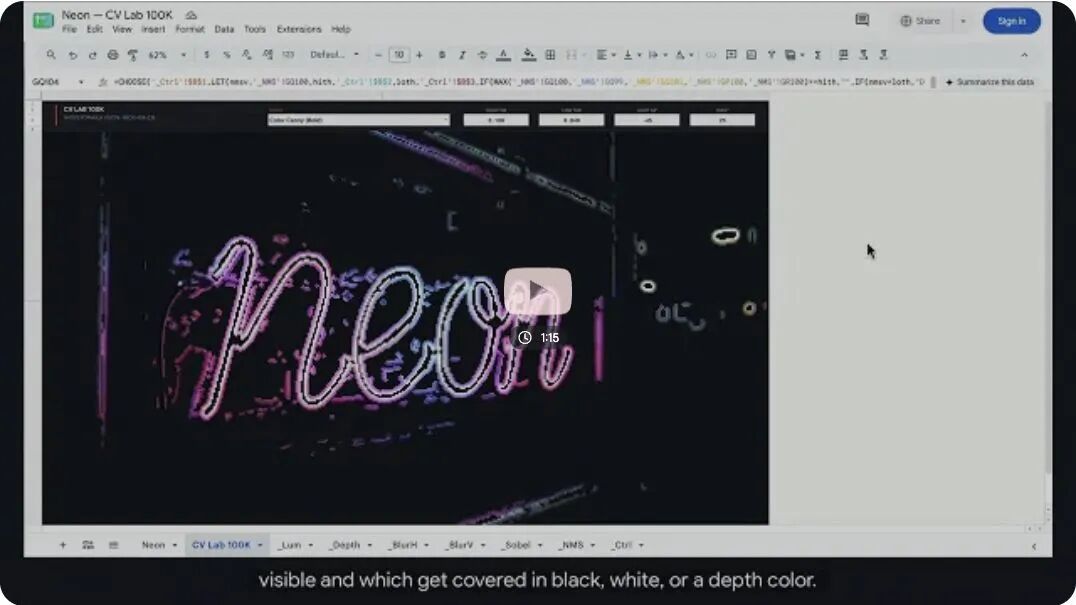
Google 官方演示|纯公式表格渲染照片
跨应用干活这块也能看出底子。
Zapier 把考场搭在了 47 个模拟应用里,销售、运营、财务全覆盖。657 项工作里,最高档的 Neon 完整做对了 370 项,通过率 56.3%。
嗯,像客户跟进这类活,发完消息顺手把客户记录改掉才算真办完,光在对话框里回一句“已完成”是没用的,这种端到端把事办利索的能力,恰恰是现在 Agent 最稀缺的。
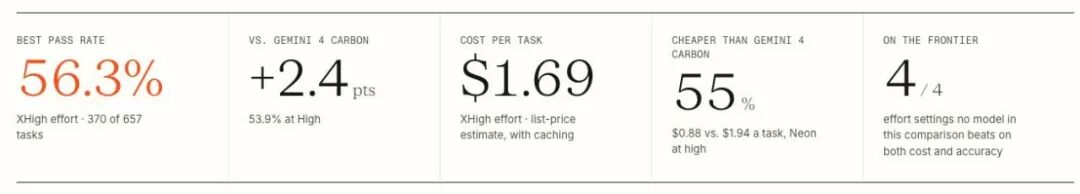
Zapier 报告|AutomationBench 通过率
代码和科研这块,谷歌还给了两组很能说明问题的数:
Terminal-Bench Science 拿了 70.5%,在专业科研终端任务上已经稳在第一梯队;而在 SWE-sweep 上,同一个 Neon,套轻量框架只有 12.8%,换到自家的 Antigravity 里直接飙到 39.0%。
同一个模型,换套外围代理工具,成绩能差出三倍。
这也挺符合谷歌一贯的打法——不光卷单点模型权重,还把底层模型和自家工具链深度捏合在一起打组合拳。
平时咱们自己测新模型也一样,其实也别光盯着榜单看,把常用的编辑器、工具链和老题目照旧留着,只换底层模型,看它第一版交得快不快、后面得自己返工几回,体感比跑分靠谱得多。
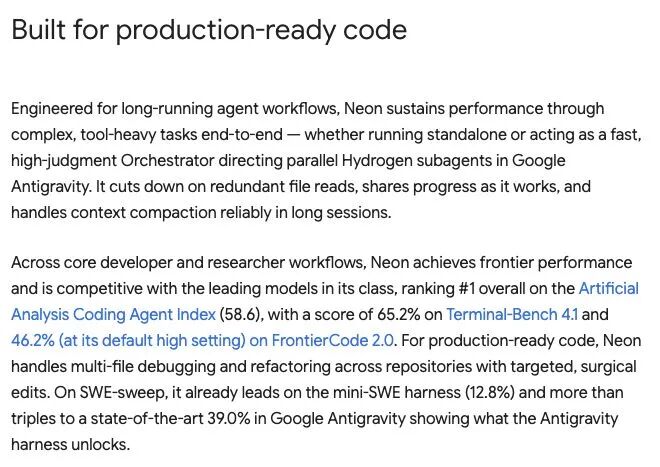
Google|不同代理框架下的 SWE-sweep 成绩
顺手刷了一圈社区的真实反馈,大家的体感也挺有意思。
即刻上「南壹」同学用很简单的提示词让 Neon 整理笔记,他的评价是内容写得挺扎实,没那么多讨厌的 AI 腔。
我这点前面也说了,我实际测试也是真的觉得内容创作少了太多 AI 味道了。
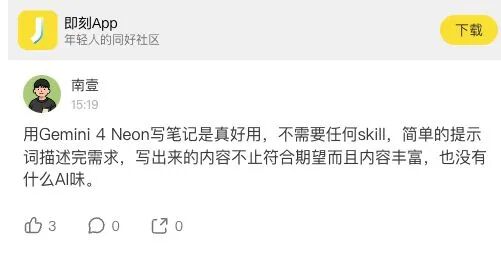
即刻「南壹」|笔记整理实测
设计师「歸藏」拿参考图试着做了几个动效组件,跑完后的结论很干脆——在他手头这类任务里,已经可以考虑把 Opus 5.5 换掉了。
说实话,能让人动念头把主力从 Claude 切过来,说明 Neon 这回确实打到痛点了。
不过底下「vikp城南」的追问也挺现实:Neon 和 Carbon 到底怎么选,之前的 Argon 又放在哪儿?
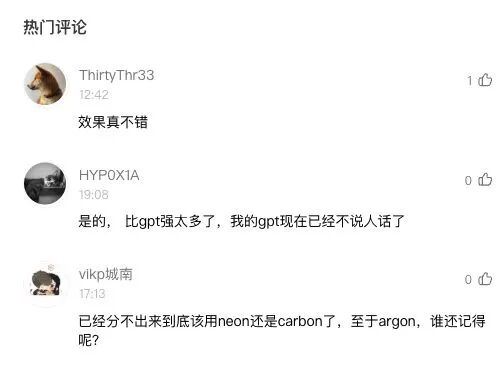
即刻评论区|动效实测与选型讨论
X 上「宝玉」干脆把分数、单价和入口拉成了一张清单,顺带把四个 Gemini 4 型号的分工重新捋了一遍。
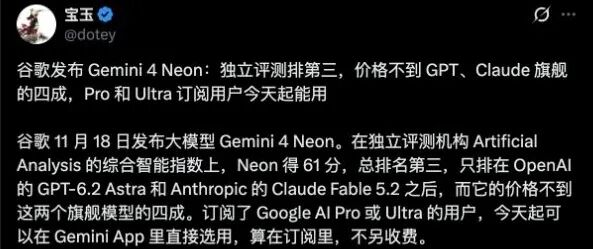
X「宝玉」|Gemini 4 家族清单
Hacker News 上吐槽得更直白。ID 为 stillpointlab 的用户显然已经被满屏的新名字搞烦了,他的英文原话翻过来大概是这样:
“新模型的名字一个接一个,我已经有点看累了。要搞懂每个新名字适合干什么,也越来越费劲。
谷歌、Anthropic 和 OpenAI 内部可能觉得分工很简单,Neon 做这个,Carbon 做那个。可大多数人还得自己把 Sol、Astra、Neon、Opus、Fable、Mythos、Carbon、Haiku 这一串名字,和实际用途一一对上。
我只希望他们最后选定一套自己满意的命名规则,然后一直用下去。不过我有点怀疑,也许这种混乱对他们都有好处。”

Hacker News|关于模型命名的吐槽
有一说一,这话确实说出了不少人的心声。既然名字越来越绕,干脆直接看账单和档位来决定怎么用。
如果能自己调推理档位,我建议直接从默认的 high 档起步。
AA 同一轮测试里,把 Neon 拉到最高档,综合分只从 60 涨到 61,但单任务平均 API 成本直接从 3.74 美元涨到了 6.44 美元。
多掏这 2.70 美元换 1 分,大多数日常场景真没必要(拿不准的时候,同一份材料跑两遍,看高档位能不能把返工时间省回来就清楚了)。
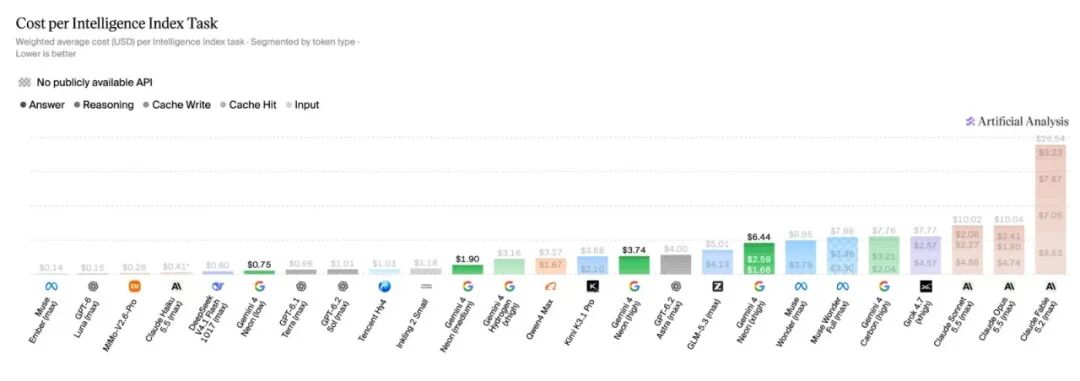
AA|不同推理档位单任务成本
接 Gemini API 的话,Neon 标价是每百万输入 3 美元、输出 15 美元,推理 token 按输出计费,文字、图片、音频和视频都能直接喂进去。
按原价算,Neon 比 Carbon 的 4 美元 / 20 美元便宜四分之一。(顺便提醒一句,Carbon 到 11 月 30 日之前还有每百万输入 2 美元、输出 10 美元的发布优惠,这十来天如果不赶速度,其实可以先薅着 Carbon 用。)
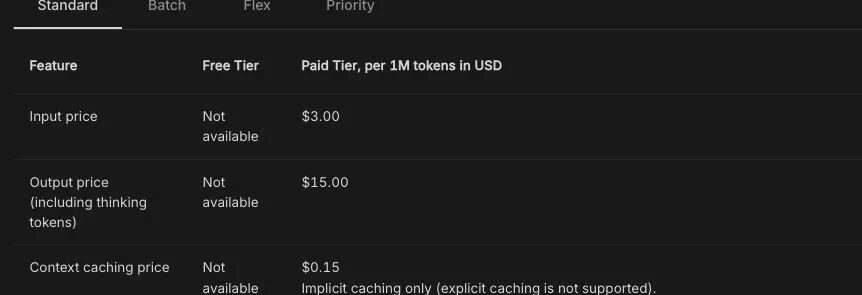
Google AI Studio|Neon API 定价
目前 Pro 和 Ultra 用户可以直接去 Gemini App 的模型选择器里切,开发者也能在 AI Studio 和付费 API 里调起来。
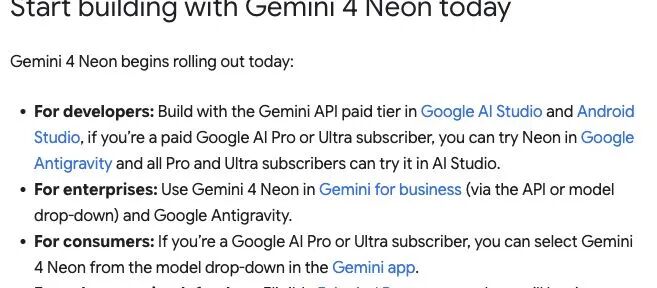
Google|Gemini 4 Neon 上线入口
最后,之前使用起来不好用的谷歌自家的反重力,这几天也是迭代很快,产品体验的短板修复后,再叠加上氖元素的威力,会发生什么样的化学反应呢?
至少,会成为竞品用户流失的催化剂!
本文由人人都是产品经理作者【AI产品大峡谷】,微信公众号:【AI产品大峡谷】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于CC0协议
内容来自 人人都是产品经理,版权归原作者所有。
阅读原文 ↗