
Google DeepMind工程师在办公室打印机上成功运行Gemma 3 270M模型
一名Google DeepMind工程师近日展示了一项颇具创意的实验:他成功在一台普通办公室激光打印机内直接运行了Google的Gemma 3 270M小型语言模型。该模型参数量约为2.7亿,而实验所用的打印机仅有14.1MB可用内存,却仍实现了每秒超过60个词元的生成速度。
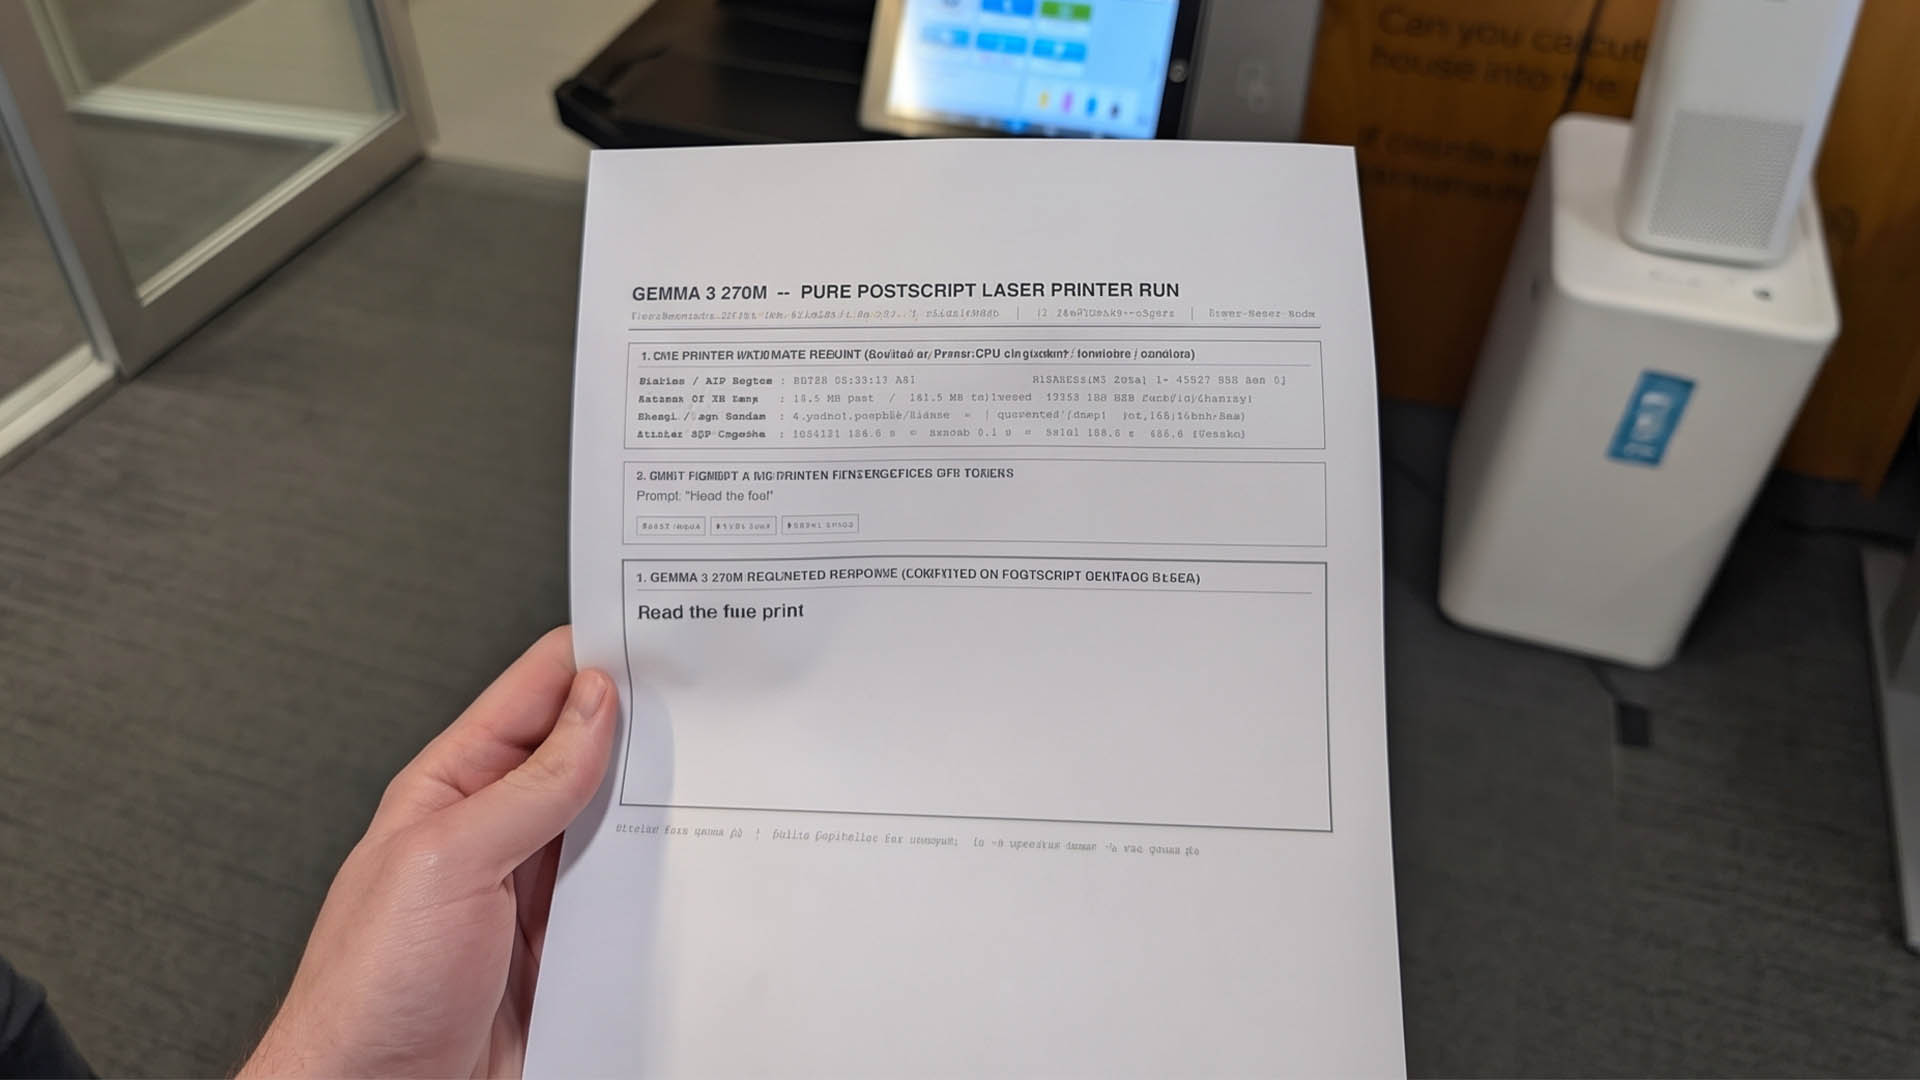
这项成果由工程师Omar Sanseviero在社交平台X上公布。他表示,在Carbon项目的帮助下,自己将Gemma模型直接运行在办公室打印机中。整个实验并未修改打印机固件,也没有外接计算板或其他硬件,而是完全依赖现代激光打印机内置的PostScript页面描述语言。
PostScript是一种图灵完备的页面描述语言,通常用于控制打印机如何呈现文字、图形和页面布局。实验团队利用Carbon这一轻量级Transformer推理引擎,并搭配经过量化处理的Gemma 3 270M模型,最终生成了一份原始PostScript打印文件。打印机在执行该文件时,实际上是在其PostScript解释器内部完成语言模型的推理计算。
为了避免模型推理过程中耗尽打印机内存,实验采用了动态层流式加载技术。系统会不断将模型的不同层调入和调出内存,使峰值内存占用仅维持在14.1MB,而打印机分配给PostScript虚拟内存的容量为244.6MB。即便如此,Gemma 3 270M仍在打印机CPU上达到了61.3 tokens/s的生成速度。
根据实验中拍摄的硬件信息,这台Ricoh打印机在PostScript Level 3解释器内原生执行了18层Transformer计算。当输入仅包含四个词元的提示语“Read the fine”时,预填充阶段耗时184秒,而生成单个词元的解码时间仅为0.1秒,整个处理过程共计184秒。
计算完成后,打印机最终将三词回答“Read the fine print”直接打印在纸上。这个结果不仅证明了模型确实在打印机内部完成了推理,也说明日常办公设备在软件层面的潜力远超人们的预期。虽然这种运行方式并不适合实际生产环境,但它展示了小型量化模型、推理引擎与既有硬件能力结合后可能达到的边界。
内容来自 cnBeta,版权归原作者所有。
阅读原文 ↗