
压力给到梁文锋一边了
DeepSeek第二轮千亿融资,落地了。
近日,DeepSeek已完成工商变更,新增股东杭州程砚。这家持股平台同期新增31家合伙人,背后包括腾讯、宁德时代、中国移动、中国电信、vivo、小红书等产业资本,以及砺思、博裕、IDG等投资机构。
自从DeepSeek开放融资之后,梁文锋似乎换了一种打法。
至少,在V4之前的版本,提起DeepSeek,还能联想到SOTA模型。但自从开启融资后,DeepSeek就把性价比、商业化放到了更重要的位置。
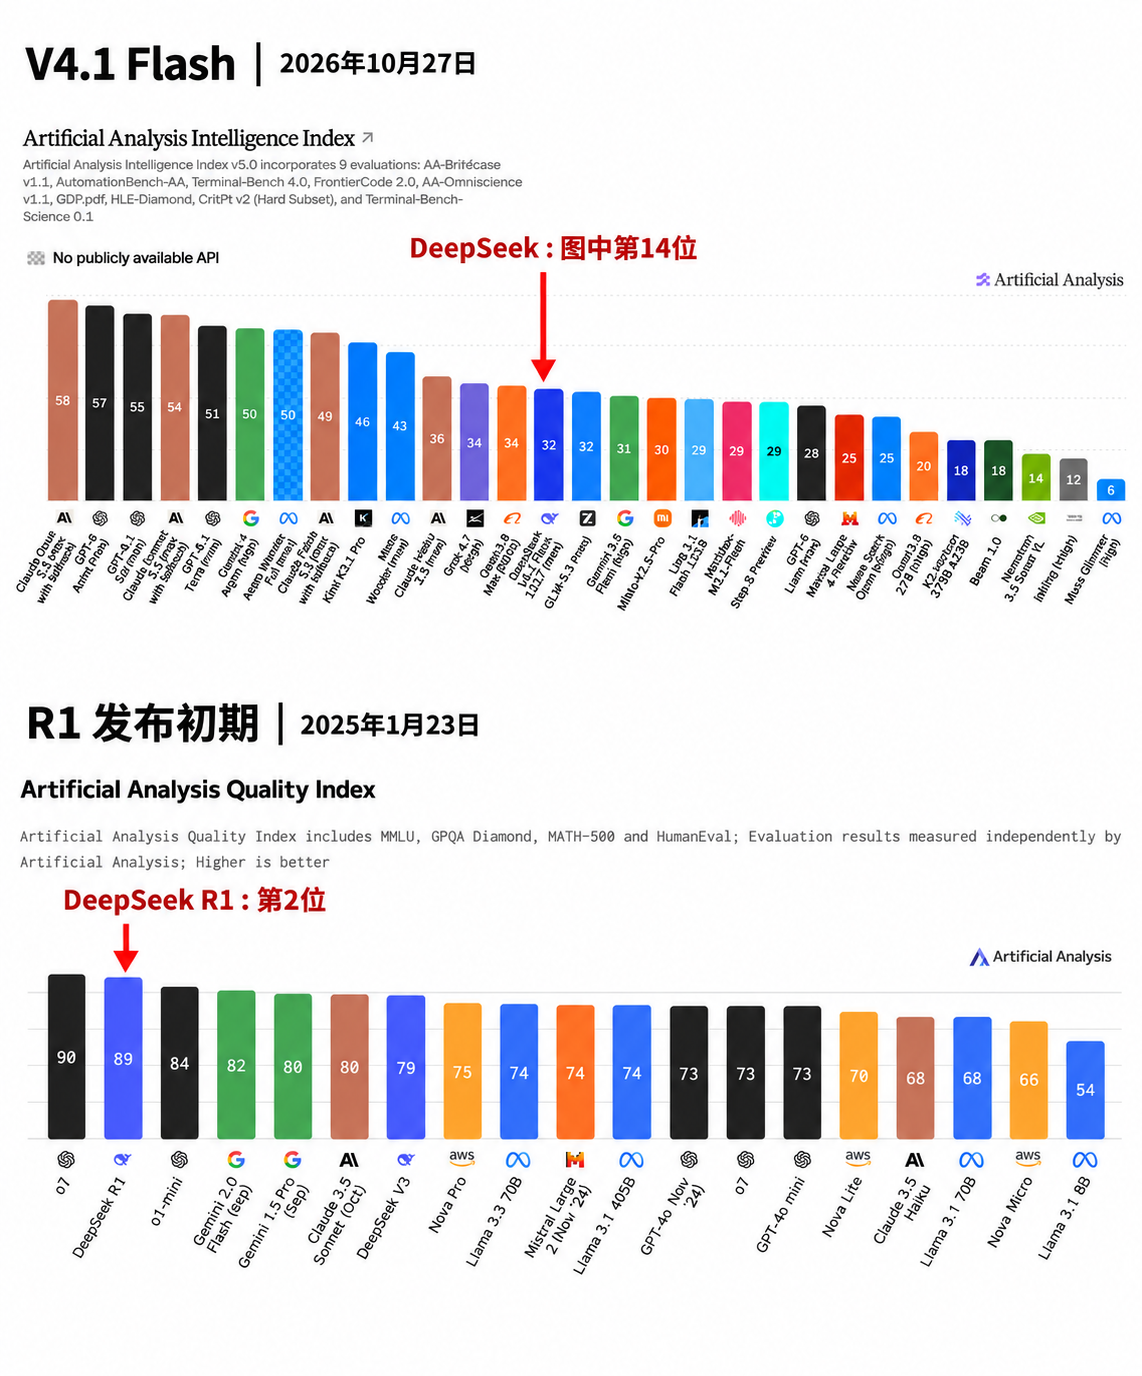
与此同时,相比于DeepSeek R1早期刚发布时的成绩,如今的版本在SOTA模型的排名中有所下降。
R1发布初期,Artificial Analysis在2025年1月23日公布的Quality Index中给出89分,仅次于OpenAI o1的90分,位居第二。到了2026年10月27日,AA的Intelligence Index榜图显示,DeepSeek V4.1 Flash 1017得分32,排名14,前面有13个模型。
11月5日,DeepSeek Harness团队在官方公众号上公布了一组使用数据:11月4日单日,日活跃用户达到154万,消耗约92万亿Token。这些数字仅统计通过DeepSeek官方API调用模型的用户,不包括接入其他模型、第三方平台或私有化部署的使用。与此同时,第三方插件已达约3.5万个,约六成活跃用户制作或安装过至少一款插件。
而就在一周后,11月13日,它开放了全家桶应用API,让开发者调用搜索、文件解析、链接阅读、语音等能力。其中,搜索、抓取、OCR和语音等项目,在模型调用费用之外另行计费。
当然,在模型调用费用之外对工具另行收费的,并不止DeepSeek一家。OpenAI的API网页搜索每千次调用收费10美元,搜索内容进入模型后还需支付相应的Token费用;文件检索则每千次调用收费2.5美元,存储另计。Anthropic的Claude API网页搜索同样每千次收费10美元,搜索结果还会产生Token费用。不过,各家的收费边界并不完全相同,例如Claude的网页抓取不额外收取工具调用费,只对进入上下文的内容按Token计费。
开放全家桶应用API的两天后,围绕DeepSeek免费用户限额的讨论开始了。但实际上,这种关于算力不足的讨论,在V4发布后就已经陆续出现了,只是当时还是开发者层面。当时,大家讨论的焦点还是Token用量激增、后台调用超出预期等。
8月14日,一名开发者在GitHub上反馈,自己用V4 Flash处理一个小项目,前一天多个任务累计消耗约7000万Token,第二天沿用同一会话,仅一个小任务就把累计用量推到了1亿。他同时提到,过程中多次调用了Playwright MCP。这起反馈指向的是长会话和工具交互带来的上下文负担:任务看起来很小,模型需要反复处理的历史却可能很大。
9月10日,另一名用户报告,自己只在已有会话里贴了三个GitHub仓库链接,让模型进行分析,三轮用户对话却在约五分钟内产生了854次API请求,最终因余额不足而中断。按其日志排查,主代理派出的子代理又继续委派任务,198次搜索工具调用进一步产生了668次计费请求;本地成本插件显示的请求量则远低于整棵任务树的实际请求量。
9月15日,有反馈,用Harness搭配V4.1 Flash调研论文,12分钟扣费54.77元,而主对话界面只显示约787万Token。他随后查看会话,发现启动了42个子代理,并附上账单和会话文件。同一帖子里,另一名用户也称,更新后的一次对话没有写任何代码,却扣了70多元。
更让用户不安的,是自己没有继续操作,账户却仍在扣费。8月25日,一名用户在GitHub上称,自己已把主会话切换到公司的GPT兼容网关,直到午饭时收到DeepSeek余额提醒,才发现个人DeepSeek账户仍被调用,最终余额耗尽。讨论中,有人将问题指向子代理沿用旧模型配置,也有人提醒联网搜索仍可能调用DeepSeek。
当然,这些是用户对特定版本、配置和任务的报告,不能简单理解为GPU算力消耗。
梁文锋要平衡的,不只是把资源投向模型研发还是商业化服务,还包括如何让已经投入的资源产生有效结果。对DeepSeek来说,是不断增长的Token消耗,能否转化为用户愿意持续付费的工作成果。这也是从低价获得关注之后,商业化必须补上的一课。
综合来看,梁文锋所面临的问题与大部分国产模型厂商类似,即在商业化和SOTA之间如何取舍。
低价之后的成本问题
过去,DeepSeek最容易让人记住的,除了模型能力,就是便宜。
低价降低了开发者的尝试成本,也让普通用户对大模型的价格有了新的预期。与此同时,开放权重让开发者可以自行研究、部署,也让其他平台能够接入DeepSeek,进一步扩大了它的使用范围。
但使用DeepSeek的人越来越多,并不意味着这些使用都能给DeepSeek带来收入。
免费服务要消耗资源,付费调用要保证响应速度和稳定性,模型研发也需要持续投入。即便技术进步降低了单次调用的成本,随着用户和Token用量增长,DeepSeek需要承担的总成本仍可能增加。
分时定价就是一种调节方式。按照DeepSeek价格页的安排,模型API分为高峰和空闲时段,高峰价格为空闲价格的两倍。对开发者来说,同样的调用,放在不同时段,费用也会不同。
当然,限额和分时定价,不能直接说明DeepSeek存在多大的算力缺口,也不足以判断它的财务状况。但这些安排背后,都涉及同一个问题:在低价吸引来大量用户之后,如何覆盖持续提供服务的成本。
而过去建立起来的低价形象,又让DeepSeek的调整多了一层难度。
用户已经习惯了免费或低价,再调整收费和额度,就会与此前的体验形成比较。对DeepSeek来说,涨价或限额能否被接受,最终还要看它提供的服务,是否值得用户付出更多。
便宜的调用未必省钱
从开发者社区的反馈来看,调用价格和实际使用成本之间,已经出现了一些差别。
在Hacker News有关DeepSeek V4.1 Flash 1017的讨论中,有用户认可它的价格、上下文容量和代码生成表现。按照这类用户的说法,主要思路由自己来定,再把执行工作交给DeepSeek,已经能够满足需要。
但也有用户提到,遇到复杂任务,模型给出的结果仍需要反复检查,有时还要交给更贵的模型修正。这样一来,即便单次调用便宜,完成整个任务的成本也未必低。
当然,这些反馈只是部分开发者的使用经历。但它们说明,至少对这部分用户来说,评价模型时,价格之外还有一笔账要算。
刚开始尝试时,用户更容易关注模型能做什么。真正用来工作之后,花了多少钱、用了多长时间,以及结果能不能直接使用,都会影响下一次的选择。
普通用户也有类似的问题。日常聊天慢几秒,影响可能不大;但如果是在赶一项工作,服务中断或长时间等待,就会打乱原来的安排。用得越深入,用户对稳定性的要求也就越高。
因此,DeepSeek要继续强调性价比,就需要让用户在完成任务之后,仍然觉得这笔钱花得值。这其中既包括调用费用,也包括检查、返工和等待所花的时间。
这也意味着,模型能力、服务稳定性和故障处理,都要跟上商业化的推进。否则,单次调用的价格再低,也可能被反复尝试的成本抵消。
对手也在降价
与此同时,低价也并非DeepSeek独有的竞争方式。
放到国内市场,DeepSeek的价格优势并没有那么明显。以输入不超过32K、缓存未命中的文本调用为例,每百万Token,DeepSeek V4.1 Flash在空闲时段的输入、输出价格分别为1元和4元,高峰时段则涨到2元和8元。
相比之下,同样按上述口径,智谱GLM-5.3-Flash每百万Token的输入、输出价格分别为0.8元和2.8元,比DeepSeek空闲时段还低;MiniMax-M3.1-Flash则为1元和4元,与DeepSeek空闲时段持平。
至于Kimi,其旗舰K3.1 Pro的输入、输出价格分别为13元和68元,仍明显高于DeepSeek V4.1 Flash。也就是说,DeepSeek相对Kimi旗舰仍有单价优势,但在智谱和MiniMax面前,便宜已经不是独有的卖点。
这当然让开发者在选择模型时,有了更多组合。简单任务可以交给便宜的模型,复杂任务则交给能力更强的模型。随着价格和效果变化,开发者也可以继续调整各家模型的使用比例。
对DeepSeek来说,这意味着,即便凭借低价获得大量调用,也未必能争取到用户更重要的任务。如果开发者只在简单工作上使用DeepSeek,把复杂任务留给其他厂商,它能获得的收入空间也可能受到限制。
因此,DeepSeek仍需要提高模型能力,让开发者愿意把更多工作交给它,而不只是因为便宜才调用它。
从这个角度看,商业化和SOTA很难完全分开。对手也在降价和升级,DeepSeek要维持性价比,就仍然需要模型能力的支撑。
开放之后如何获得收入
在这样的背景下,从Harness到DeepSeek开放全家桶应用API,也就都不难理解了。
按照官方解释,过去开发者要实现类似DeepSeek App的功能,需要自己接入外部工具,再处理模型与工具之间的调用。现在,这些工作可以更多地放到DeepSeek服务端完成。
也就是说,除了模型调用,DeepSeek还希望通过搜索、文件解析、语音等服务,为开发者省去一部分接入和维护工作,并从中获得收入。
但工具越多,需要保证的服务环节也越多。开发者购买的是一整套能力,搜索、文件或语音中的任何一环出了问题,都可能影响最终结果,也会影响他们对DeepSeek的评价。
此外,开放模型带来的影响力,如何转化成DeepSeek自己的收入,也仍是一个问题。
用户可以通过第三方平台使用DeepSeek,由平台提供服务并收取费用;企业也可以自行部署,再由其他供应商负责运营。这些使用都能扩大DeepSeek的影响,但收入未必直接流向DeepSeek。
因此,扩大模型的使用范围之后,DeepSeek还需要让开发者愿意直接购买官方服务。除了模型本身,官方能否提供更方便、稳定的使用体验,也会影响这部分收入。
全家桶API是在补充这部分能力。但开发者是否愿意持续使用,最终仍要看它能省去多少工作,以及新增的费用是否合适。
对于梁文锋来说,这些问题都要在推进商业化的过程中逐一处理。免费用户需要资源,付费用户要求体验,模型研发也不能停。有限的资源如何分配,既影响眼下的服务,也会影响下一代模型的竞争力。
DeepSeek过去依靠技术效率和低价获得了关注。到了商业化阶段,它还需要把这些优势转化为持续的收入,再支撑后续的研发和服务投入。综合来看,梁文锋要做的,是在推进商业化的同时,继续保持模型的竞争力。
另一个变化是,海外厂商在推进商业化的同时,也没有放慢模型更新。Anthropic已于11月18日完成IPO定价,计划于19日在纳斯达克开始交易,上市已到最后一步。模型方面,仅11月以来,Anthropic就于9日发布了Claude Fable 5.2和Mythos 5.2,继续提升编程、推理和视觉能力;17日,OpenAI又推出GPT-6.2 Astra和Sol,分别面向复杂推理与编程,以及日常编程和Agent任务。
相比之下,DeepSeek V4从4月24日首次发布算起,到11月19日已过去近7个月;即便从8月13日V4 Pro正式版上线算起,也已有3个多月。这期间,DeepSeek在9月10日推出V4.1 Flash,又在10月17日更新了1017版本,模型能力仍在提升,但截至11月19日,新一代Pro旗舰还没有亮相。
对梁文锋来说,眼下的压力并不小。
内容来自 虎嗅,版权归原作者所有。
阅读原文 ↗