
元示科技获近 3 亿元 Pre-A 融资,资本正在寻找生物医药的 Foundation Model
虚拟细胞正被资本押注为生物医药的下一个 Foundation Model。元示科技拿下近 3 亿元 Pre-A,君联资本领投、多家产业资本跟投。这份股东名单背后,是资本在赌「更早判断一次干预是否有效」的能力。
当AI在Coding领域的演进逐渐收敛,全球科技与风险投资界都在寻找下一个超级战场。越来越多的一线共识正指向生物医药。如果说Coding重构了数字世界的生产方式,解码生命规律则将直接重塑生物世界与人类健康。
但在漫长复杂的生物医药链条中,究竟哪一个层级才具备诞生“生物学Foundation Model”的可能?2026年,产业界与资本市场将多数选票投给了虚拟细胞(AIVC)。
ZF独家获悉,继连续完成近亿元人民币天使轮及天使+轮融资后,近日,元示科技完成近3亿元人民币Pre-A轮融资,刷新了国内AIVC领域的单笔融资纪录。本轮融资由君联资本领投,华夏瓴投、招商局中国基金、京东关联基金、鼎晖VGC、CMC资本跟投,老股东Monolith、创新工场、道彤投资、燕缘创投持续加注本轮,光源资本担任本轮融资独家财务顾问。
融资规模之外,这份股东名单也提供了一个观察窗口:具有不同产业背景与投资经验的机构,为什么会在虚拟细胞这一仍处早期的方向上相遇?
答案需要放在更大的产业变化中寻找。大模型公司正在把生命科学布局延伸到科研工具、专业团队和实验流程;医药产业则始终面对一个难题:如何更早判断一次干预能否产生预期效果,以及它可能带来什么风险。
两条线索在这里交汇。理解虚拟细胞的价值,需要先回答两个问题:大模型为什么越来越关注生物?细胞模型,又能为理解生物学和制药产业提供什么?
大模型为什么走进生物实验室
2026年,前沿AI公司在生命科学领域的动作,已经深入到科学家实际工作的环节。
Anthropic在4月收购计算生物学公司Coefficient Bio,6月推出科研工作台Claude Science,并在公司披露中确认建设分子生物学实验室。从连接科研数据库与分析工具,到补充内部实验能力,其布局正逐步覆盖提出问题、分析数据与获得实验反馈的过程。
OpenAI则在推出生命科学模型与工具Rosalind之后,于10月宣布收购Orchestra Bio,将能力延伸至药物研发项目的组织和推进。Google推出的Gemini for Science,也把假设生成、计算实验等任务纳入科研工具体系。
这些动作各有侧重,却共同提示了一种变化:AI正在更深入地参与产生知识的过程。
生命科学的吸引力首先来自真实而复杂的需求。研究人员需要在大量文献、实验结果和专业工具之间往返,形成假设、设计实验、解释异常,并决定下一步做什么。模型在推理、编程和工具调用方面的进步,使它开始能够承担其中更多工作。对于大模型公司,这是一个能力进步可以转化为实际研发价值的领域。
更深一层的机会,来自生物学尚未被充分测量的部分。已有论文和数据库能够告诉模型人类已经发现了什么;一个新的干预在新的生物背景下究竟会怎样,往往仍然需要实验给出答案。
这使实验具有双重价值:它可以解决眼前的研究问题,也可以为模型提供新的学习材料。假设经过验证,错误被记录,尚未覆盖的条件进入下一轮实验,模型才有机会持续修正对生命系统的判断。
从这一角度看,大模型公司对生物的投入,有着比工具销售更长远的意义。谁能把科学问题、实验执行和结果反馈持续连接起来,谁就更有机会获得下一轮模型进步所需要的证据。
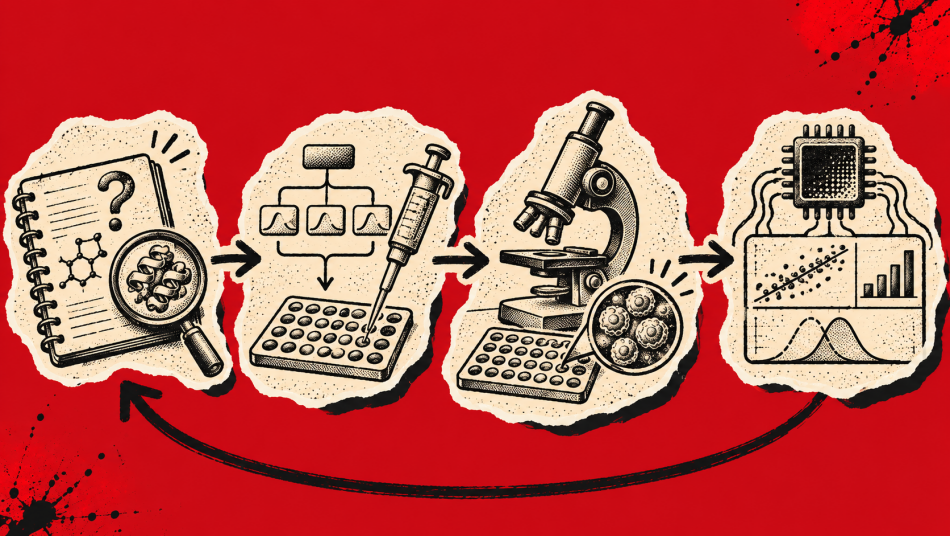
科研流程:提出问题、设计实验、执行实验与结果反馈
细胞为什么成为基模载体
但大语言模型能够组织科研流程,并不意味着它已经掌握了生命系统的运行规律。研究工作越深入,越需要能够处理具体生物问题的模型。
生物学的不同尺度提供着不同信息:DNA序列记录遗传信息,蛋白质参与分子作用,细胞则把这些变化汇成可以观察的生命活动。增殖、分化、应激乃至死亡,都发生在具体的细胞背景中。同样的干预,面对不同类型、不同状态的细胞,结果可能相差很远。
虚拟细胞试图学习的,正是这些状态及其变化:一个基因被抑制、一种药物被加入、周围环境发生改变之后,细胞会如何响应?
这也揭示了虚拟细胞与生物基础模型之间的关系:生物基础模型旨在从海量生物数据中学习具有泛化能力的底层规律,而虚拟细胞则是这一技术路线在细胞尺度上的体现,并与其他尺度的生物模型在数据与能力上相互支撑。发表于《Cell》的虚拟细胞路线图,也将分子、细胞与多细胞尺度的模型连接,以及跨模态学习,列为这一方向的重要组成部分。
其中,一个关键是让不同测量真正对应起来。基因表达提供细胞活动状态的重要线索,蛋白测量、显微影像和功能实验则提供其他侧面的信息。来自同一细胞,或具有可靠对应关系的样本,能够帮助模型把这些观察联系到同一生物状态上。这种连接需要实验设计与数据质量共同支撑。
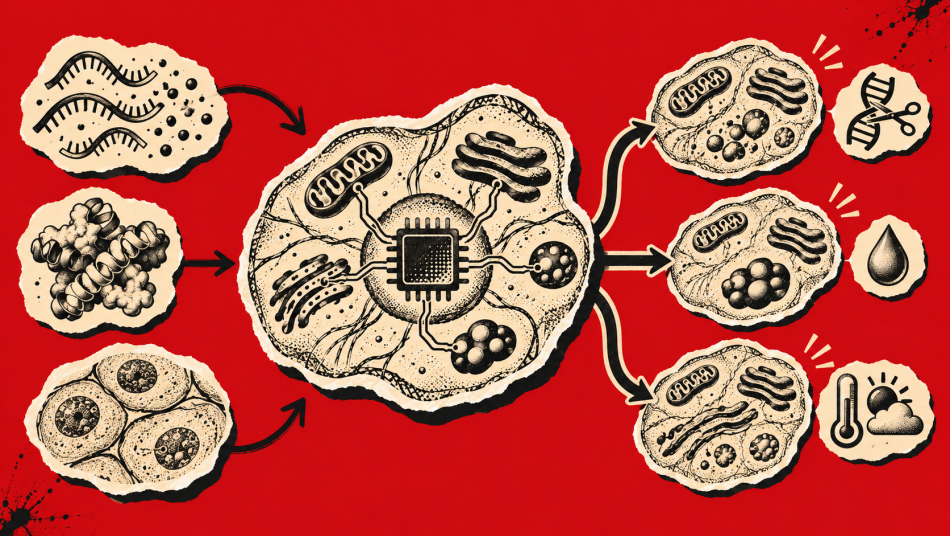
虚拟细胞:整合多模态信息,预测不同干预下的细胞响应
另一个关键是干预带来的证据。观察到某个基因的异常与疾病同时出现,尚不足以判断改变它会发生什么。明确的干预、匹配的对照与重复实验,才有助于判断某项操作在特定条件下造成了哪些变化。这样的数据能够检验模型预测,也能逐步缩小机制解释的范围。
因此,细胞层的重要性,在于它同时连接了不同尺度的观察与可以反复验证的变化。更广泛的生物模型可以在这里检验假设,细胞模型也可以吸收来自序列、蛋白和其他测量的信息,改善自身预测。
Arc Institute推出的全球首个具备泛化能力的虚拟细胞模型STACK,提供了一个理解这一方向的例子。它让细胞样本本身成为提示,利用已有背景中的信息,推断另一组细胞在相应条件下的转录响应,无需针对每个目标数据集重新微调。它探索的是一个直接关系到模型通用性的问题:已知实验中的规律,能否帮助我们理解尚未充分测量的生物背景?
据了解,STACK模型唯一第一作者董明泽已全职加入元示科技。这让元示科技在早期就拥有了直接参与国际前沿细胞模型研发的核心人才。前沿研究者走向产业,也使这一轮虚拟细胞创业多了一个值得观察的维度:模型研究能否与持续的数据生产和真实研发问题更紧密地结合。
分子之后,才是制药
细胞模型为何受到关注,放到药物研发中会更容易理解。
礼来CEO David Ricks曾提到:“找到一个可以结合靶点的分子只是第一步。研究人员还需要判断,这个靶点是否真正与疾病相关、改变它能否产生预期疗效,药物进入人体后会不会出现无法接受的毒性。对于这些问题,现有AI模型仍然存在明显局限。”
这些判断贯穿靶点验证、临床前研究与临床开发。即使分子与靶点的相互作用被准确预测,关于疾病机制、细胞响应和人体安全性的证据,仍然需要继续积累。分子设计的进步,使候选方案的搜索更加高效;如何判断哪些方案值得继续投入,则决定这些进步能在多大程度上转化为药物。
Google DeepMind的Pushmeet Kohli在近期讨论中提出,谈AI加速药物研发,需要具体到究竟加速了靶点发现、先导分子优化、临床前研究还是毒理等环节。更大幅度的进步,有赖于对相关生物学问题和模型的进一步突破。
虚拟细胞的产业价值,可以沿着这一思路理解:它有望帮助研发人员更早形成关于疗效与风险的判断,并把有限的实验资源用到更值得验证的问题上。
例如,面对多个候选干预,团队可以先比较它们对疾病相关细胞状态的预测影响,选择优先验证的方案;面对同一干预在不同样本中的差异,可以进一步寻找可能受益的患者特征;面对潜在风险,则可以将正常细胞的异常响应纳入下一轮实验。
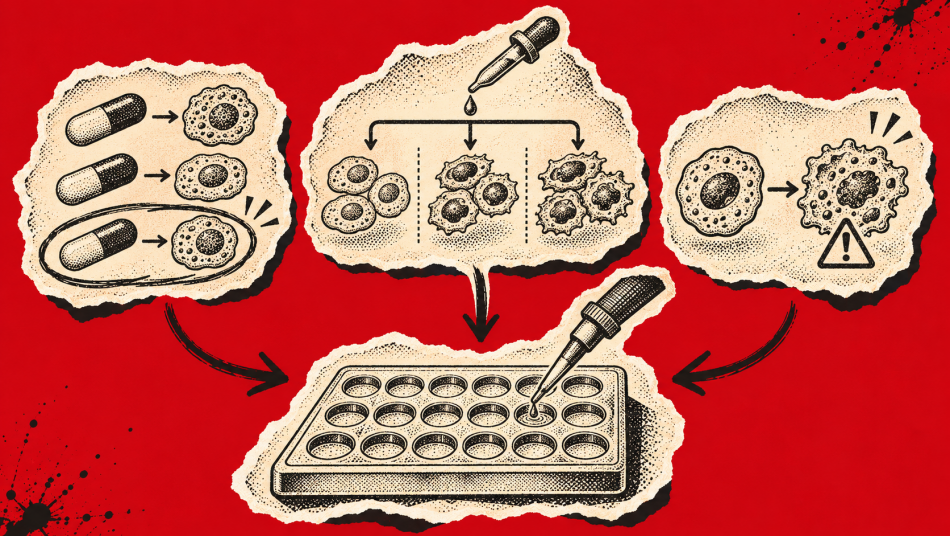
研发应用:比较候选方案、探索响应差异与识别潜在风险,随后实验验证
这些能力需要在具体任务中逐一验证。细胞层面的预测也仍需与组织、器官以及临床证据衔接。但对研发团队而言,只要模型能够在关键节点提供可靠增量,就可能影响一次实验的选择、一个候选分子的排序,乃至一条管线是否继续推进。
这赋予虚拟细胞一个清晰的价值起点:在更早的研发阶段,让原本模糊的生物学不确定性变得更可判断。
下一道门槛是持续产生有效证据
沿着上述逻辑,虚拟细胞竞争中的一个核心问题也逐渐浮现:模型所需要的数据,究竟从哪里来?
公开数据库为生物模型提供了重要起点。但面向具体的干预预测任务,数据是否覆盖了相关细胞背景,是否包含可靠对照,不同测量能否对应,实验条件是否清楚,都会影响模型能够学到什么。
重复测量大量相似的细胞,可以增加样本数,却未必补足某种罕见状态、某个关键干预或某类患者背景中的信息缺口。对于需要向新场景迁移的模型,有效覆盖与测量质量同样重要。
Arc在介绍2026年虚拟细胞挑战赛的数据工作时,也特别强调跨细胞背景预测对数据一致性和质量的要求:技术差异与噪声可能掩盖真正的生物学信号。挑战本身说明,模型要跨越的障碍,既涉及算法,也涉及用于学习和检验的实验数据。
由此,数据生产需要成为模型研发的一部分。团队应当根据目标任务组织实验,把干预、细胞背景、响应测量与匹配对照联系起来;再依据模型的错误,识别哪些条件尚未覆盖、哪些实验最可能补足关键信息,并让新结果进入下一轮训练和验证。
这就是干湿闭环值得关注的原因。它的价值体现在一个具体问题上:每增加一轮实验,模型是否获得了此前缺少的证据,并在独立留出的任务中表现得更好?
衡量这样的体系,需要同时观察数据与结果。有效干预覆盖是否扩大,不同模态是否可靠对应,单位合格数据的生产成本能否下降;进一步,预测的改善能否经受新实验检验,并真正帮助客户作出研发选择。
一旦这些环节持续运转,单次项目积累的数据与经验沉淀才有机会反哺后续研究。这既是平台价值复利增长的基石,也是递归自我改进(RSI)在生物基础模型中的具体体现。
在董明泽看来,RSI远不局限于模型自身的迭代。“RSI在AI for Biology和LLM中底层逻辑是一致的:找到真正制约能力进步的瓶颈环节,并通过AI持续赋能、突破这一限速步骤。”他认为,一个理想的RSI体系,应当覆盖AI研发的完整流程,从软件算法,数据收集到硬件基础设施,系统性地识别并突破各个环节的效率瓶颈。不同领域的RSI不需要遵循完全相同的路径,关键在于能否准确识别当前阶段最具约束性的环节,并让每一轮改进带来下一轮研发效率和模型能力的提升。只有当这种自我改进能力延伸至整个研发体系,才有可能形成推动AGI指数级发展的长期动力。
再回到元示科技的融资,不同资本的关注可以从这些相互连接的需求中理解。
从硬科技投资的视角看,值得关注的是模型能力能否跨任务复用,以及实验反馈能否支持持续学习;从医药产业的视角看,关键在于疗效、风险和患者差异能否更早获得判断;从产业投资的视角看,稳定的数据生产与研发协作,又可能成为可以长期积累的基础能力。
这些价值分别来自不同领域,却在细胞模型上形成了交集:生命科学需要更有预测力的模型,模型需要更有信息量的实验,医药研发则需要两者共同提供更可靠的决策依据。
本轮近3亿元的早期融资,为观察这种交汇提供了一个鲜明样本。虚拟细胞能否成长为生物医药的重要基础设施,最终取决于它能否在一个又一个新的问题中,把可验证的预测转化为可使用的证据。
这些问题元示科技又该如何回答,我们拭目以待。
资料来源:
[1] Anthropic, Claude Science, an AI Workbench for Scientists, June 30, 2026.
[2] Anthropic, Corporate Public Disclosure: Acquisition of Coefficient Bio and Molecular Biology Laboratory, November 11, 2026.
[3] OpenAI, OpenAI Acquires Orchestra Bio, October 20, 2026.
[4] Google Research, A New Era of Discovery: Google Research at I/O 2026,May 28, 2026.
[5] EPFL AIMM, How to Build the AI Virtual Cell, December 2024.
[6] Arc Institute, Stack: Simulating Cellular Conditions via Prompt Engineering, Without the Need for Fine-Tuning, January 9, 2026.
[7] Latent Space, “Why AlphaFold Didn’t Solve Protein Folding — Pushmeet Kohli, Google DeepMind & Sal Candido, Biohub”, October 10,2026.
[8] Arc Institute, Generating High-Quality Perturb-seq Data for the 2026 Virtual Cell Challenge, October 1, 2026.
作者:Z Finance 公众号:Z Finance
本文由 @Z Finance 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自作者提供
内容来自 人人都是产品经理,版权归原作者所有。
阅读原文 ↗