
OpenAI 全新发布 GPT-6.2 双模型:价格,又打下来了
OpenAI 同时放出 GPT-6.2 的 Astra 与 Sol:Astra 每百万输入 8 美元、输出 40 美元,Sol 维持 2 美元与 10 美元。能力与预算怎么塞进同一套路由,才是开发者真正要算的账,几个官方数字先说清楚。
OpenAI 这次同时发布 GPT-6.2 Astra 和 GPT-6.2 Sol,把模型产品矩阵拉得更清楚:Astra 面向科学、法律、金融和复杂专业工作,Sol 面向快速、通用的日常任务。
两款模型都接入 ChatGPT Work、Codex 和 API,但价格与能力边界不同。Astra 的 API 价格是每百万输入 Token 8 美元、缓存输入 0.4 美元、输出 40 美元;Sol 维持每百万输入 2 美元、缓存 0.1 美元、输出 10 美元。
这篇发布稿最值得开发者关注的,不是哪个模型在总榜更高,而是如何把专业任务、日常任务、预算和安全能力放进同一个路由系统。
Astra 的定位:高复杂度专业工作
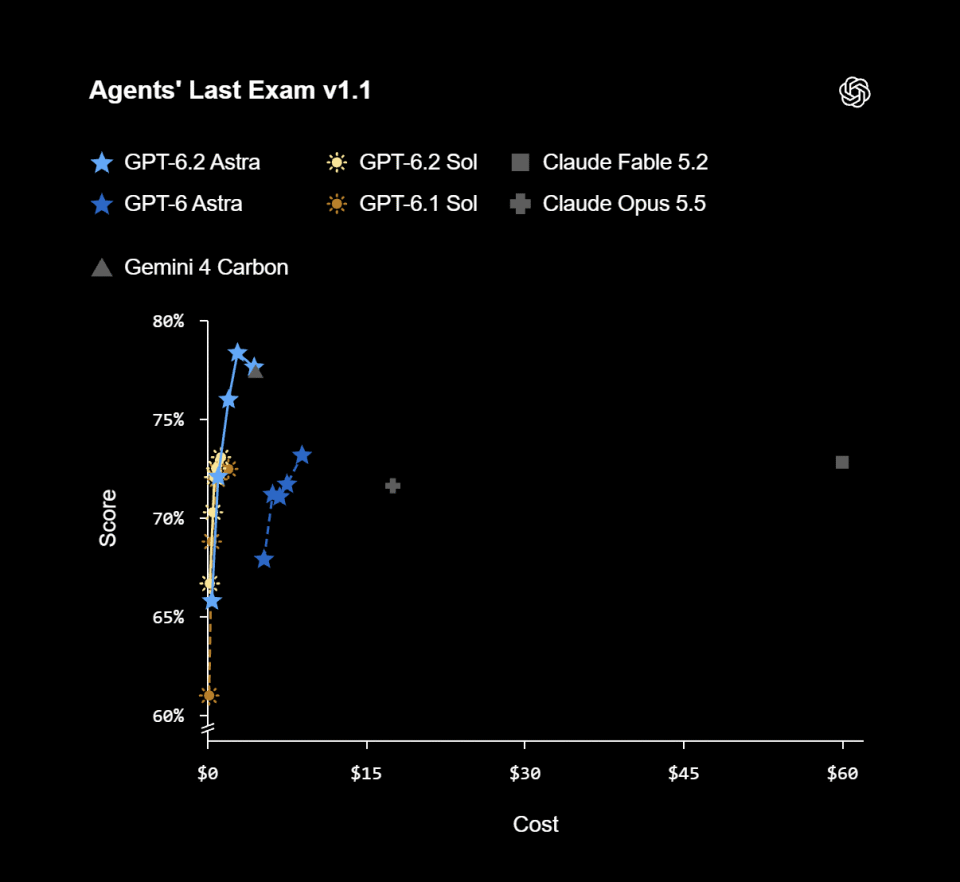
Astra 针对法律、金融、科学、设计和复杂 Agent 工作优化。OpenAI 公布的 Agents’ Last Exam v1.1 中,Astra 比前代 GPT-6 Astra 高 5.2 分,任务成本不足前代三分之一;与 Claude Fable 5.2 相比,得分高 5.5 分,成本约为对方的 5%。
在 Harvey LAB-AA 合同分析测试中,OpenAI 称 Astra 通过率超过 Claude Fable 5.2 的两倍,成本约为其六分之一;GDPval-v2 中覆盖咨询、金融和设计任务,得分较前代提高 6.2 个百分点,输出 Token 减少 22%。
这些数字来自官方披露,仍需要结合独立评测和自身业务验证。Epoch AI 的测试显示,Astra 在能力指数中与 Claude Fable 5.2 持平,但在一些真实研究任务上出现偏离核心问题、反复无效修正和过于保守的情况。
因此,专业模型的选型不能只看“通过率”,还要看它是否能持续围绕任务目标工作,能否主动说明文件缺失、工具不可用和关键假设不成立。
Sol 的定位:让高频任务更便宜
Sol 主要面向日常任务和通用工作。在 FrontierCode 2.0 中,Sol 比 Astra 低 0.5 分,但单任务成本约为 Astra 的五分之一;Artificial Analysis 智能指数中,Sol 得分 57,单任务成本约为 GPT-6 Astra 的 15%。
这类差距对 Agent 很重要。一个普通任务可能触发多轮搜索、代码修改、测试和工具调用,如果每一步都使用高价模型,最终账单会很快超过用户预期。Sol 更适合作为默认模型,负责计划草稿、常规代码修改、文档整理、分类和低风险自动化。
但 Sol 并不等于“低配 Astra”。在部分编码和法律测试中,Sol 出现得分下降,SWE-Atlas-QnA-AA 中甚至下降 14 分,回答遗漏关键事实的情况增加。它适合高频,但仍需要上下文校验和失败升级策略。
评测结果出现明显分化
多家机构的结果说明,两款模型并没有形成一个简单的“全面第一”结论:
| 评测方向 | Astra 表现 | Sol 表现 |
|---|---|---|
| 科学与数学 | Terminal-Bench-Science、Vals Science Index 领先 | 成本更低,部分测试仍在前列 |
| 三维设计与机器人 | AA-3D 1318 Elo,AA-Robotics 79 分 | AA-3D 1259,机器人 78 分 |
| 通用智能指数 | 62 分,排名第二 | 57 分,成本约为高价模型 15% |
| 编程 Agent | 高强度配置与前代旗舰接近 | 成本低,但部分事实型编码任务下降 |
| 法律任务 | 通用模型排名靠后,专用 Astra for Law 更高 | 进一步落后,需要谨慎路由 |
Astra 在 FrontierMath Erdős 测试中完成 68 道题中的 7 道,证明通过 Lean 形式化验证;但复杂研究任务仍可能偏离目标。评测的价值不是告诉你“永远选谁”,而是帮助你知道哪些任务需要更强的约束和人工检查。
长上下文和工具调用,不代表自动可靠
两款模型都支持百万 Token 上下文,工具调用次数接近前代的两倍,但最终答案更短。工具调用增加,意味着模型可以更细地拆任务、查询资料和验证结果;也意味着权限、超时、重试和外部副作用会更复杂。
生产环境需要为工具调用增加控制面:
- 每类任务允许调用哪些工具;
- 工具调用的最大次数和预算;
- 文件缺失、搜索失败和 API 超时如何处理;
- 结果不确定时是否暂停并请求确认;
- 外部操作是否有幂等键、回执查询和回滚。
模型越能自主调用工具,越不能把工具接口设计成“拿到 Token 就能执行一切”。
安全能力上升,风险阈值也同步上升
OpenAI 表示,Astra 是首个达到 AI 自我改进能力“高”风险阈值的对外模型。公司认为它可以实质性加快 AI 研究,因此增加了研究环境控制、Control Room 监控和推理行为标记。
网络安全方面,内部 ExploitBench 测试中 Astra 成功将已知浏览器漏洞转为可用攻击程序的比例超过 50%,测试关闭了安全防护和分类器,与默认产品环境不同。OpenAI 也表示,会增加更严格的滥用防护,但这可能同时限制正常漏洞研究和安全测试。
开发者不能把“模型默认拒绝”当成完整安全策略。高风险任务仍应放在隔离环境,限制凭证、目标范围和网络权限,并保留人工审批和终止机制。模型的能力阈值越高,运行时的安全责任越不能只依赖供应商。
如何设计 Astra/Sol 的生产路由
可以先从一个简单矩阵开始:
- 默认使用 Sol 处理低风险、高频、上下文有限的任务。
- 当任务涉及复杂法律、金融、科学、三维设计或百万 Token 资料时切换 Astra。
- 当 Sol 连续两轮失败、遗漏关键事实或出现工具异常时升级 Astra。
- 对生产发布、资金操作、漏洞利用和敏感数据导出强制人工确认。
- 记录每次升级的原因、成本、成功率和人工接管结果。
模型路由不是一次性配置,而是一个需要持续评估的产品。随着价格、额度、模型版本和业务任务变化,阈值也应随之调整。
国内团队如果希望通过 API 统一接入 GPT-6.2 Sol/Astra 等模型,可以了解 [Code80]https://code.ai80.vip/home 这类渠道;但模型矩阵、预算、密钥和高风险审批仍需自行维护。
常见问题
Astra 是否适合所有任务?
不适合。它更适合复杂专业工作和高难度 Agent 任务,普通问答、格式整理和常规代码修改使用 Sol 更经济。
Sol 的价格低,是否意味着质量不够?
不一定。它在部分真实代码和长流程任务中接近 Astra,但在某些法律和事实型编码测试中出现下降,需要配置失败升级和事实校验。
为什么独立评测和官方评测会不一致?
测试数据、工具框架、推理强度、输出上限和成功标准不同。模型能力必须结合自身任务基准判断。
Astra 的安全风险阈值意味着什么?
意味着它可能显著加速 AI 研究和网络安全工作,也需要更强的运行环境隔离、行为监控和人工终止机制。
如何控制 Astra 的高价调用?
把 Astra 用在复杂规划、最终审查和高价值任务上,普通步骤交给 Sol;同时设置 Token、工具次数、运行时长和美元预算。
国内团队如何接入两款模型?
可以通过 Code80 等 API 渠道降低接入摩擦,但仍需自行配置模型路由、数据脱敏、权限、审计和成本上限。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议
内容来自 人人都是产品经理,版权归原作者所有。
阅读原文 ↗