
WorkBuddy 上免费用 Hy4 flash,推荐我的邪修玩法!
混元推出 Hy4 flash,原生支持文本与图像输入,上下文到 1M token,11 月 30 日前在 WorkBuddy 上免费。作者用它加自己的邪修玩法做出了苏轼人生轨迹三维地图,任务书怎么拆、阶段怎么验收,都写清楚了。
先来看我用 WorkBuddy + Hy4 flash 开发的《一蓑烟雨:苏轼人生轨迹 · 三维考据地图》
其实不是 Hy4 flash 独立完成的,我动用了一些邪修玩法,后面详细介绍
Hy4 flash 限时免费了
前些天我刚写过 WorkBuddy 绝配大模型,Hy4 正式版实测!超预期了
当时测试 Hy4 正式版,它在长程任务、复杂代码、视觉理解上的表现确实超出了我的预期
没想到,最近腾讯动作这么快,这才过去短短十来天,正式推出并开源了全新的 Hy4 flash,它是混元系列迄今性价比最高的大语言模型,原生支持文本和图像输入,可生成文本,上下文长度可达 1M token
我看了下开源权重文件,后面如果有量化版本,4bit 版本压到 150GB 以下完全没问题,应该算是成本最低的可本地部署Flash系模型了
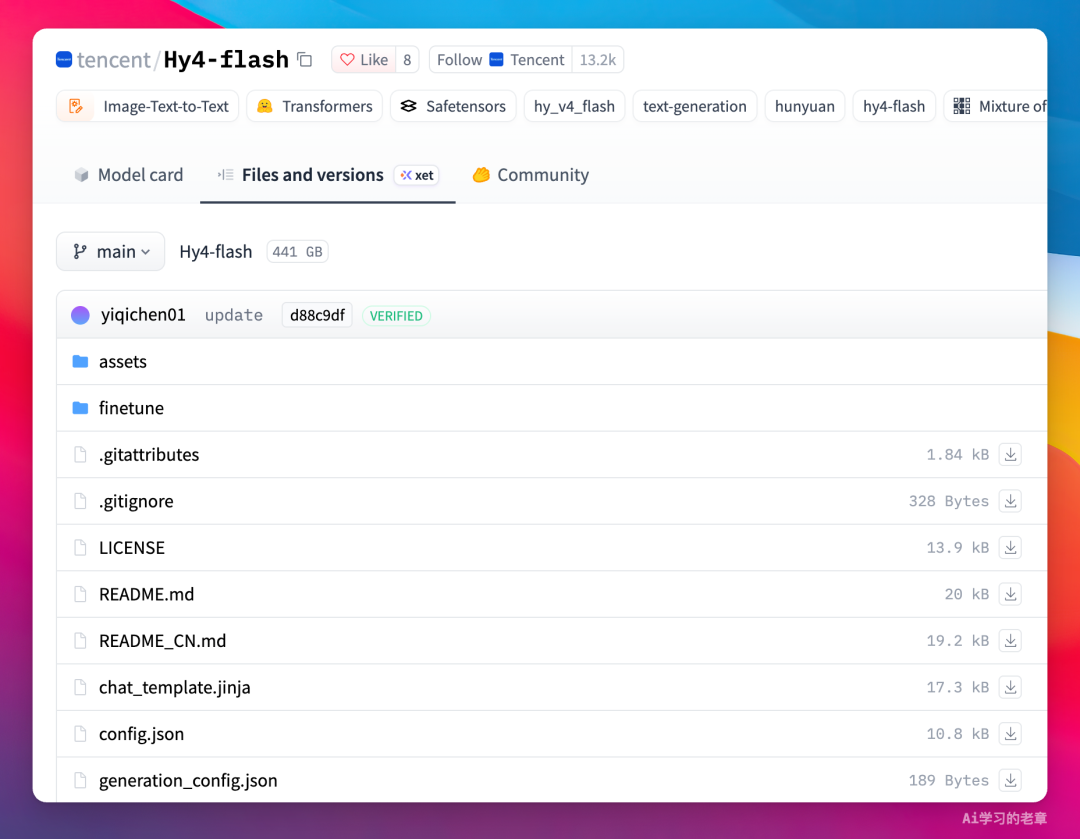
我感觉混元的策略是 Hy4 负责冲顶,攻坚高难度长程代码与顶级推理;Hy4 flash 则卡位高频落地场景,把推理速度、Token 效率和性价比推到极高水平
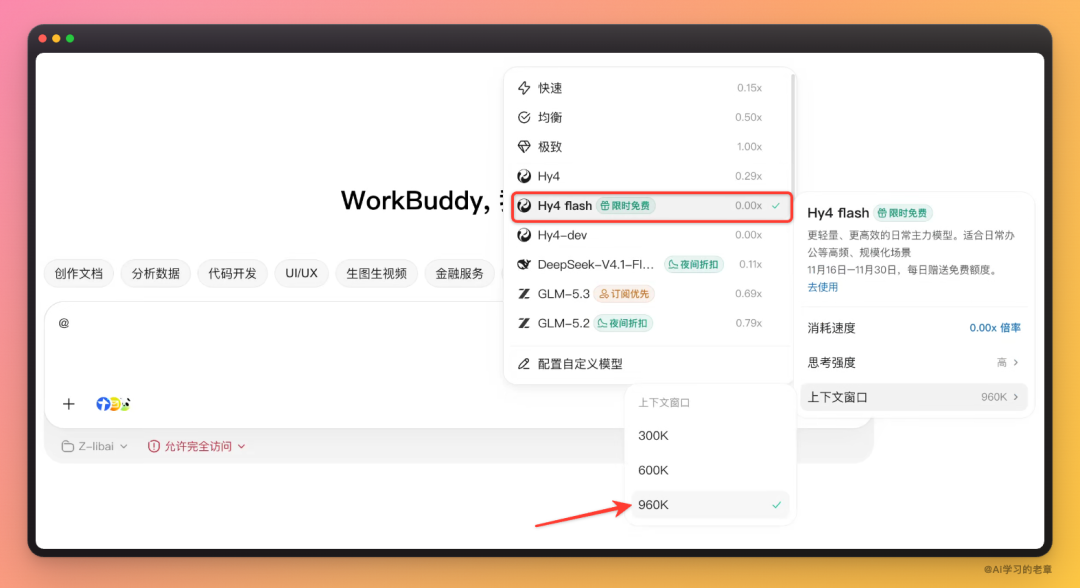
十分建议大家尝试一下 Hy4 flash ,11 月 30 日之前 在 WorkBuddy 中限时免费使用,顺便提醒一下,使用时记得修改上下文窗口至 960K
Hy4 flash 价格击穿行业底线
关注 AI 圈的朋友会发现,今年下半年各大厂商都在疯狂推 Flash 系列模型
根源在于 Agent 应用的全面爆发,日常 Token 消耗量被推高了一个数量级
以前大家用大模型往往是单轮问答,几千个 Token 就能搞定;现在跑一个完整的自动化工作流,动辄涉及网页采集、几十步工具调用、代码自测、格式渲染,单次任务跑下来消耗几十万甚至上百万 Token 成了家常便饭
如果所有活都交给顶级旗舰模型,再厚的钱包也撑不住天天这么烧
大模型的竞争维度已经转移:比拼的标准从单纯刷榜的“能力上限”,转变成了单位任务成本
目前市面上拥有极致性价比名号的当属 DeepSeek-V4.1-Flash-1017,我对比了一下两边的 API 价格,Hy4 flash 居然只有 DeepSeek-V4.1-Flash-1017 的一半
| 模型 | DeepSeek-V4.1-Flash-1017 | Hy4 flash |
|---|---|---|
| 输入价格(未命中缓存) | 空闲 1.00 元 / 高峰 2.00 元 / 百万 tokens | 0.50 元
/ 百万 tokens |
| 输入价格(命中缓存) | 空闲 0.02 元 / 高峰 0.04 元 / 百万 tokens | 0.02 元
/ 百万 tokens |
| 输出价格 | 空闲 4.00 元 / 高峰 8.00 元 / 百万 tokens | 2.00 元
/ 百万 tokens |
| WorkBuddy 端内使用 | 按正常积分消耗 | 限时完全免费(11 月 30 日前) |
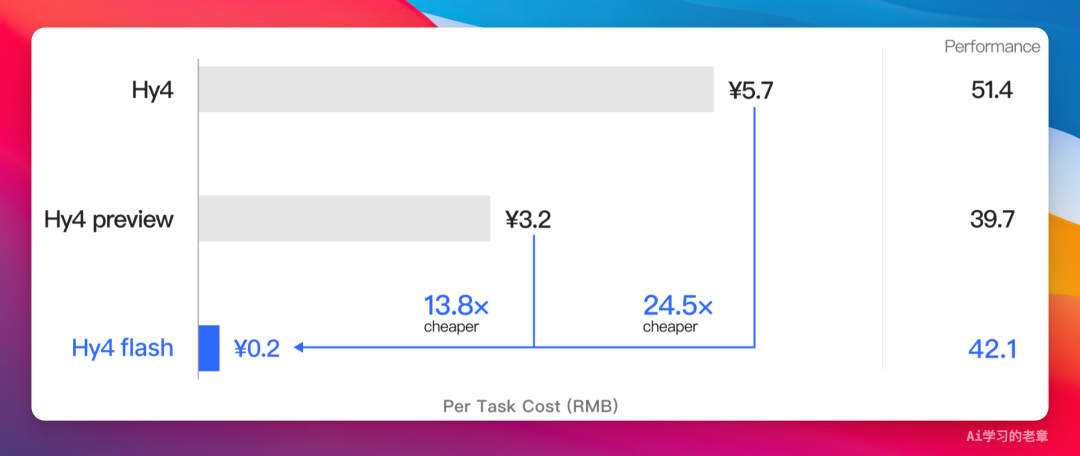
看它与自家 Hy4 的对比,更能看到这种价格的优势
Hy4 flash 速度与 Token 效率都很高
这两天我在 WorkBuddy 里用涵盖前端代码、行业研报、可编辑演示文稿生成的多任务环境,对几款主流 Flash 模型在 WorkBuddy 做了一轮同场竞技
具体表现有点太主观了,不太好评价。耗时、模型调用次数、工具调用次数、Token 消耗这些客观数据放一下(3 个任务合计):
| 核心指标 | Hy4 flash | DeepSeek-V4.1-Flash | MiniMax-M3.1-Flash |
|---|---|---|---|
| 端到端总耗时 | 24.5 分钟 | 57.7 分钟 | 69.1 分钟 |
| 模型调用总轮次 | 158 次 | 248 次 | 290 次 |
| 工具调用总次数 | 160 次 | 285 次 | 391 次 |
| 总输入 Token 消耗 | 1,246 万 | 3,083 万 | 4,761 万 |
| 总输出 Token 消耗 | 12.1 万 | 27.5 万 | 35.3 万 |
| 首个动作响应时延 | 5.9 ~ 9.3 秒 | 7.2 ~ 125.6 秒 | 9.5 ~ 23.1 秒 |
提醒一下,测试不一定公平,因为 DeepSeek 绝配 Harness 可能是 DSH,MiniMax 绝配可能是 MiniMax Code,不同渠道本身也会影响速度
但就 WorkBuddy 中表现看,Hy4 flash 任务执行速度与 Token 效率都相当有优势
按未命中缓存的价格粗算上限,Hy4 flash 三个任务约 6.5 元(输入 1246 万 × 0.5 元 + 输出 12.1 万 × 2 元)。DeepSeek 按闲时价约 32 元,高峰时段约翻倍。单价只便宜一半,任务成本却差了 4~5 倍
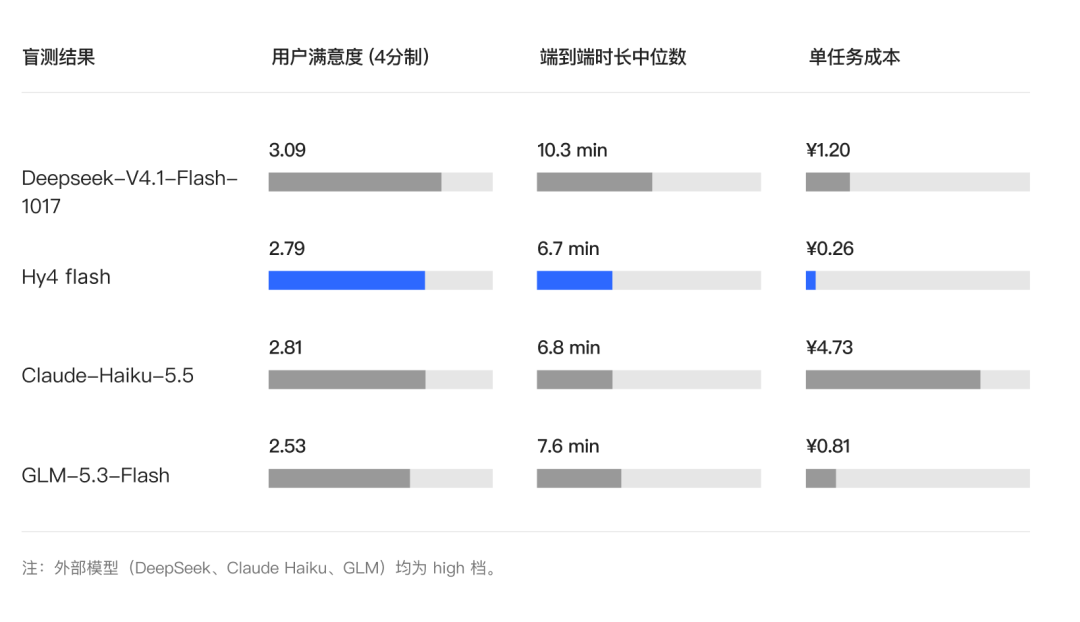
我的实测结果和混元公布的用户盲测结果比较吻合
Flash 模型到底该怎么用
在大多数编程与日常自动化任务中,60% 到 80% 的 Token 消耗其实都堆在底层的代码实现与数据预处理上
Flash 系列的核心使命,就是承接高频度、高并发、需要极快响应、且全天候跑起来毫无成本负担的真实工作流
我的基操:拆解方案、定架构、做最终验收交给旗舰模型,比如 Opus 甚至 Fable;具体搬砖打字、批量铺代码、采集/清洗数据交给 Flash
具体操作,我常用玩法有二
1 是旗舰模型生产的 Skills 交由 Flash 执行
别误会,Flash级别的模型也不全都可以胜任,比如我经常提及的 Ai 帮我看视频,然后将核心内容整理成图文并茂网页的案例
我的一点经验:给 Flash 用的 Skill,示例比规则管用。规则和示例冲突时,小模型会照着示例来,所以一定要放 1~2 个完整示例
Grok Bot 核心工程师土豆姐最新一个访谈视频,总时长 1个小时,嘉宾不只她一个,没有字幕
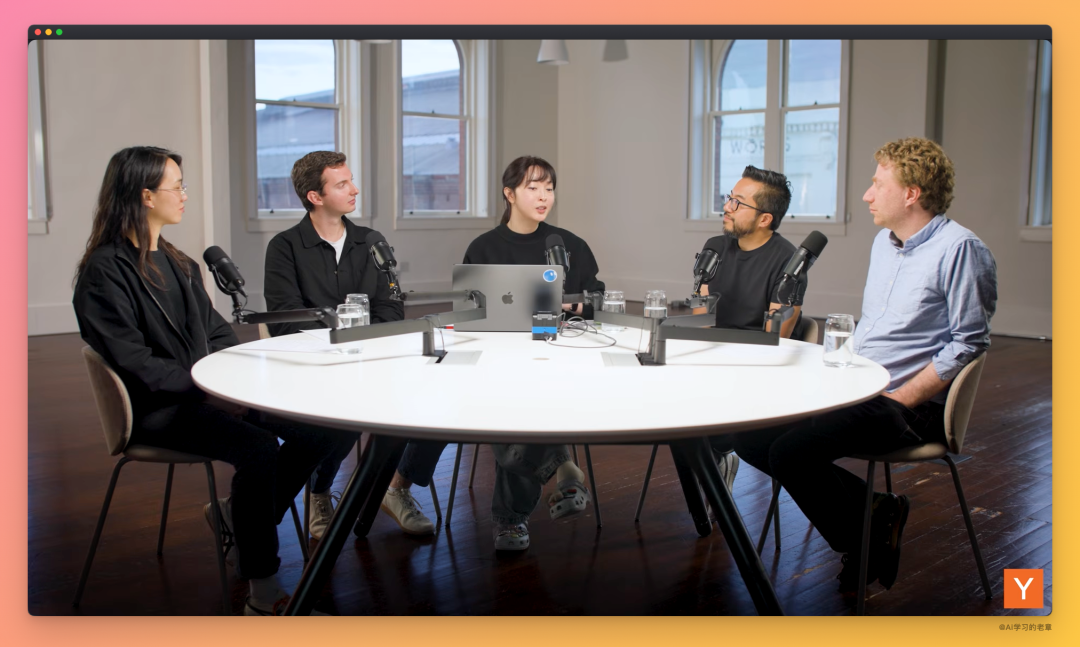
视频交给 Hy4 flash,调用我的 video2webpage Skills,它就开始帮我“看”视频了
这里建议给 flash 下指令的时候加上一句:“严格按 Skill 步骤执行,不要跳步。每一步做完先对照示例自检,再进入下一步。”
实际操作,Hy4 flash 做转录、翻译、从视频中找到关键帧,抽取画面,制作网站一气呵成
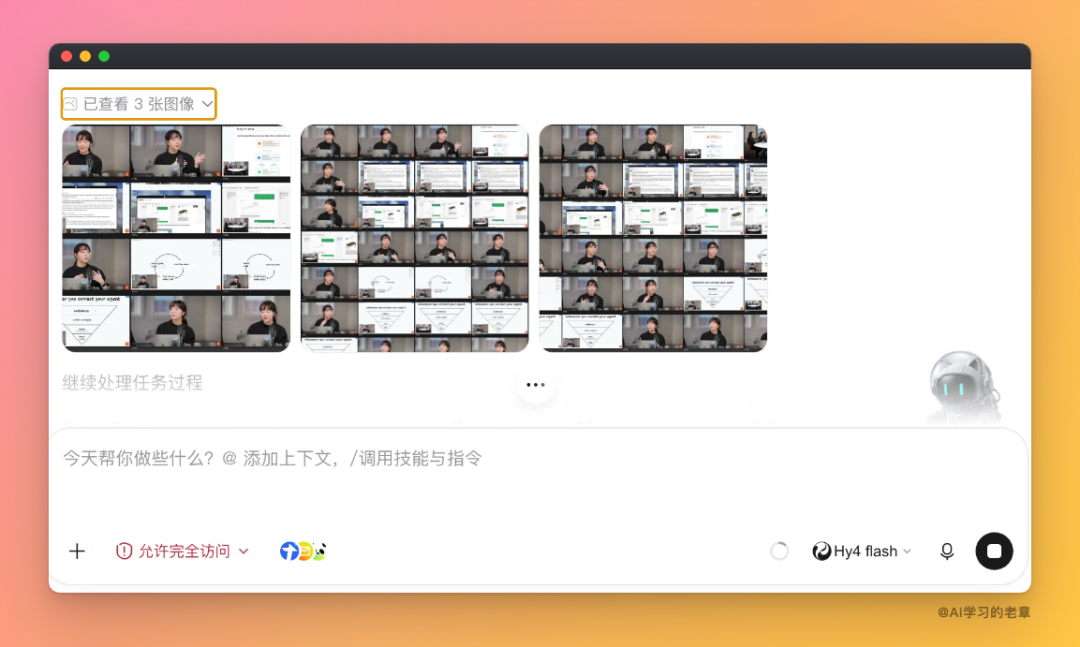
最终输出一份结构化数据和网页
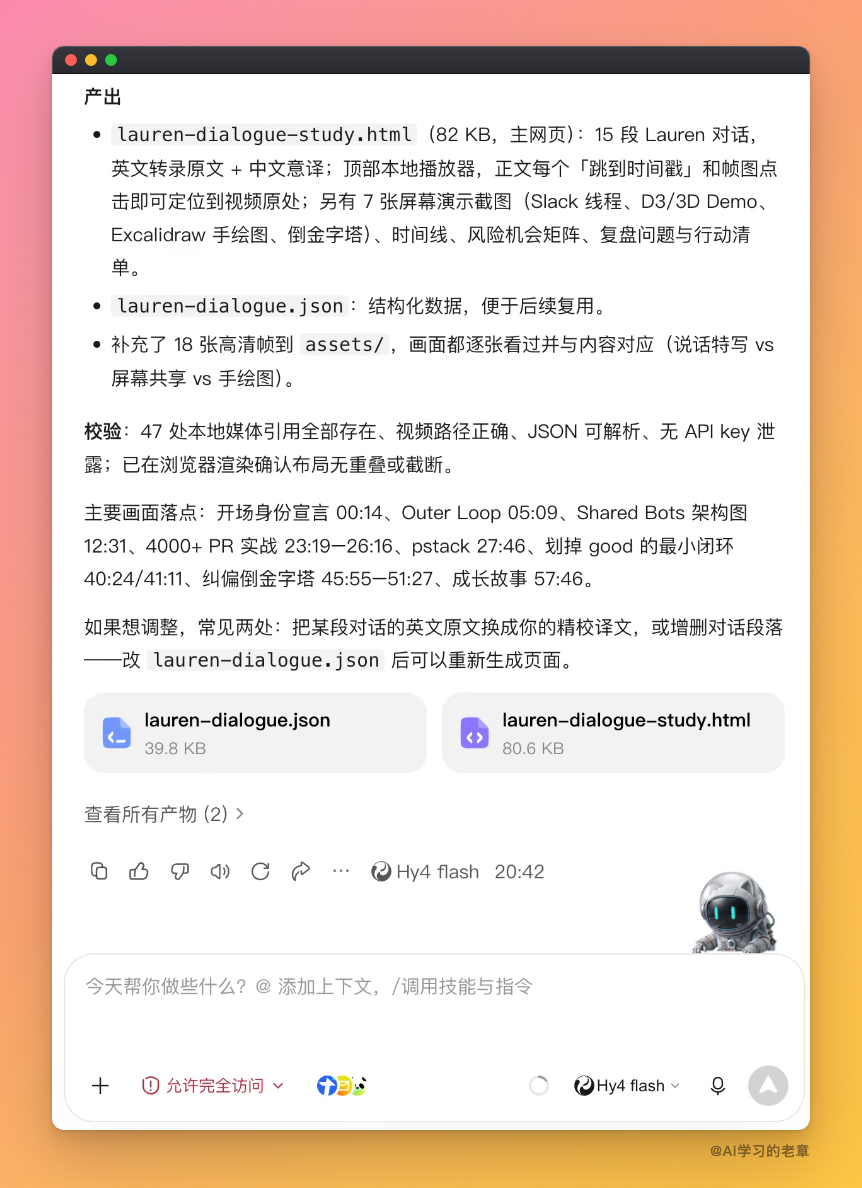
网页设计,效果如下,页面中所有带时间轴的地方都可以一键跳转到原视频
看这个比刷视频,快进跳转找干货方便、效率提高不知道多少倍
玩法2:旗舰大模型手把手带 Flash 工作
这手段就多了,同一家模型可以配置subagent,这种玩法比较适合 Claude Code
模型跨厂商了,我喜欢直接动用 Computer use,比如用 Claude Code + Opus5.5 去操作 WorkBuddy,这样其实也有点费主力模型的额度
更省心的还是让旗舰模型搭好脚手架,写好提示词让 Flash 干耗时、耗Token的活儿
比如文章开头那个项目就是这样
首先我让 Hy 4 这种旗舰模型给 Hy4 flash 制定详细计划,核心提示词:“把这个项目拆成 Flash 能一次做对的阶段任务。每个阶段写清楚输入、产出和验收标准,拿不准的先问我。”
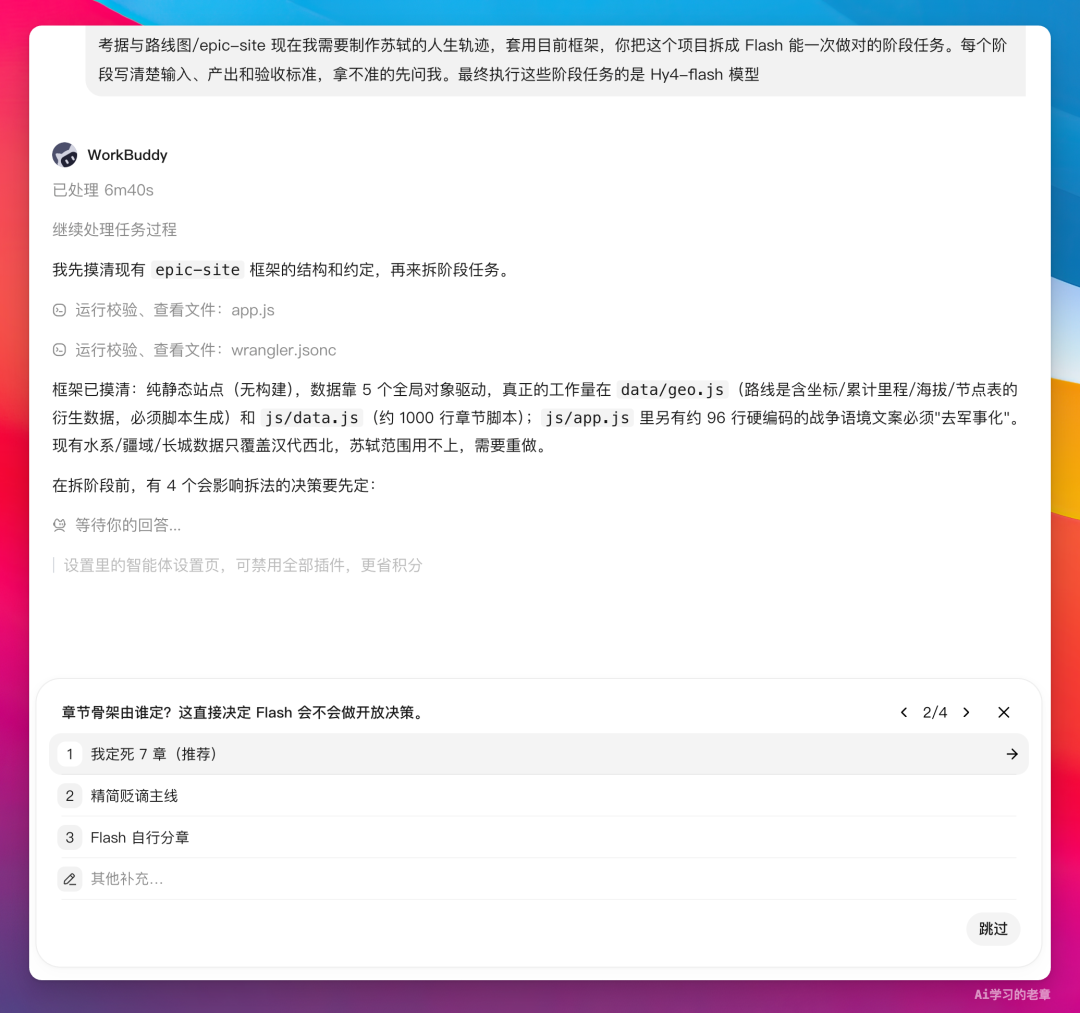
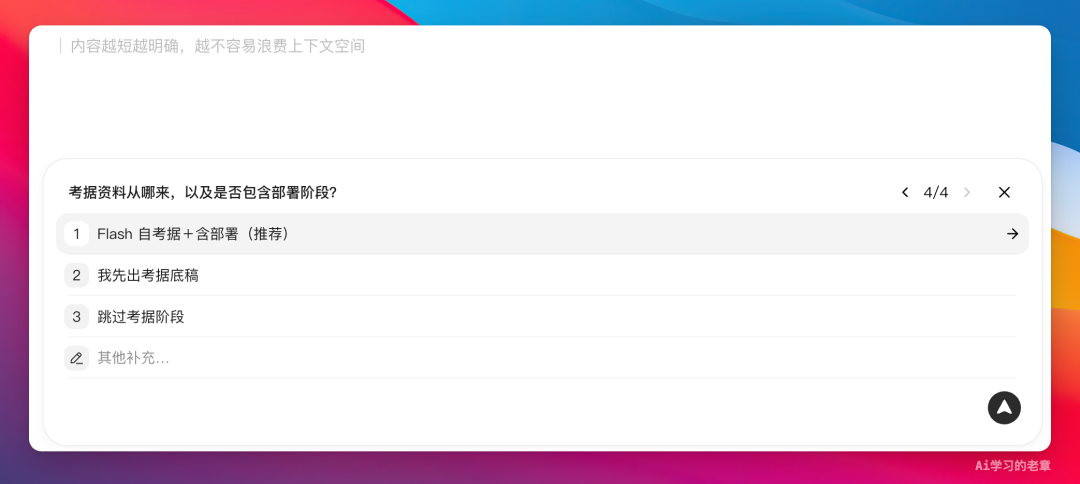
Hy4 会根据要求拆解任务,框定哪些工作是需要 Hy4 flash负责的
最终输出一份详细的阶段任务书给到 Hy4 flash
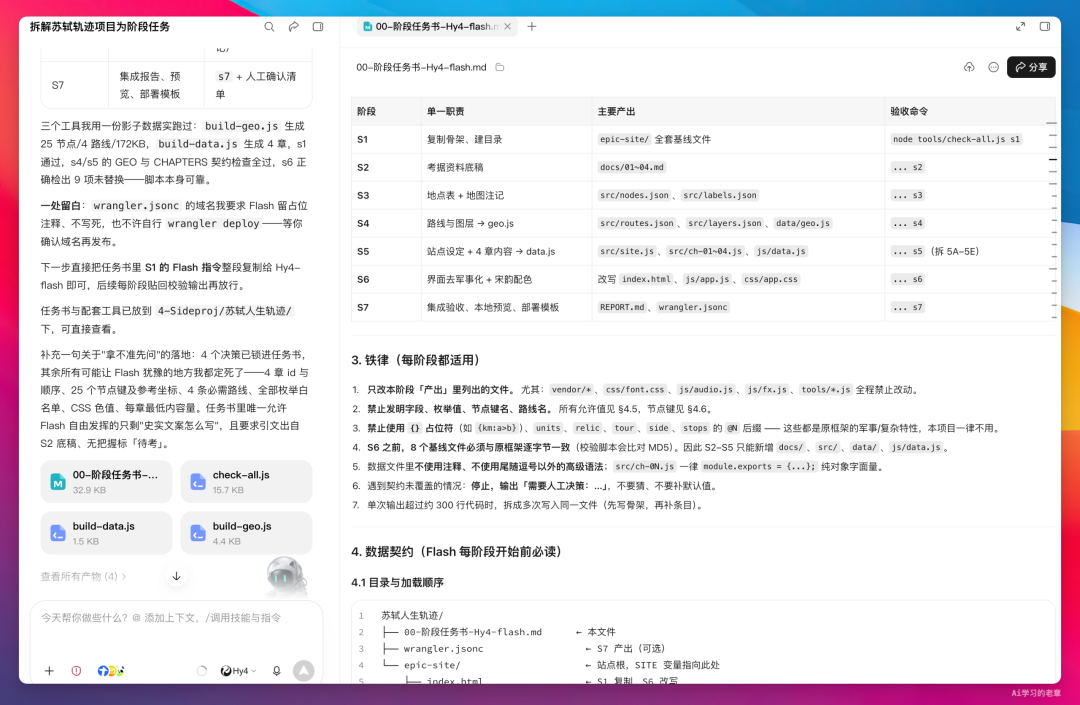
我仔细看了一下任务书,Hy4 写的提示词核心有四块:
- 最终目标和验收标准(成品长什么样才算完成)
- 分阶段任务清单(资料收集 → 筛选 → 建模 → 页面 → 部署)
- 每个阶段的自检要求(做完先自查再进入下一步)
- 禁区(哪些不许改、不确定时怎么处理)
然后新建一个 WorkBuddy 分组给 Hy4 flash,把任务书交给它
这里建议加上一句语:严格按照任务书要求完成每一阶段任务
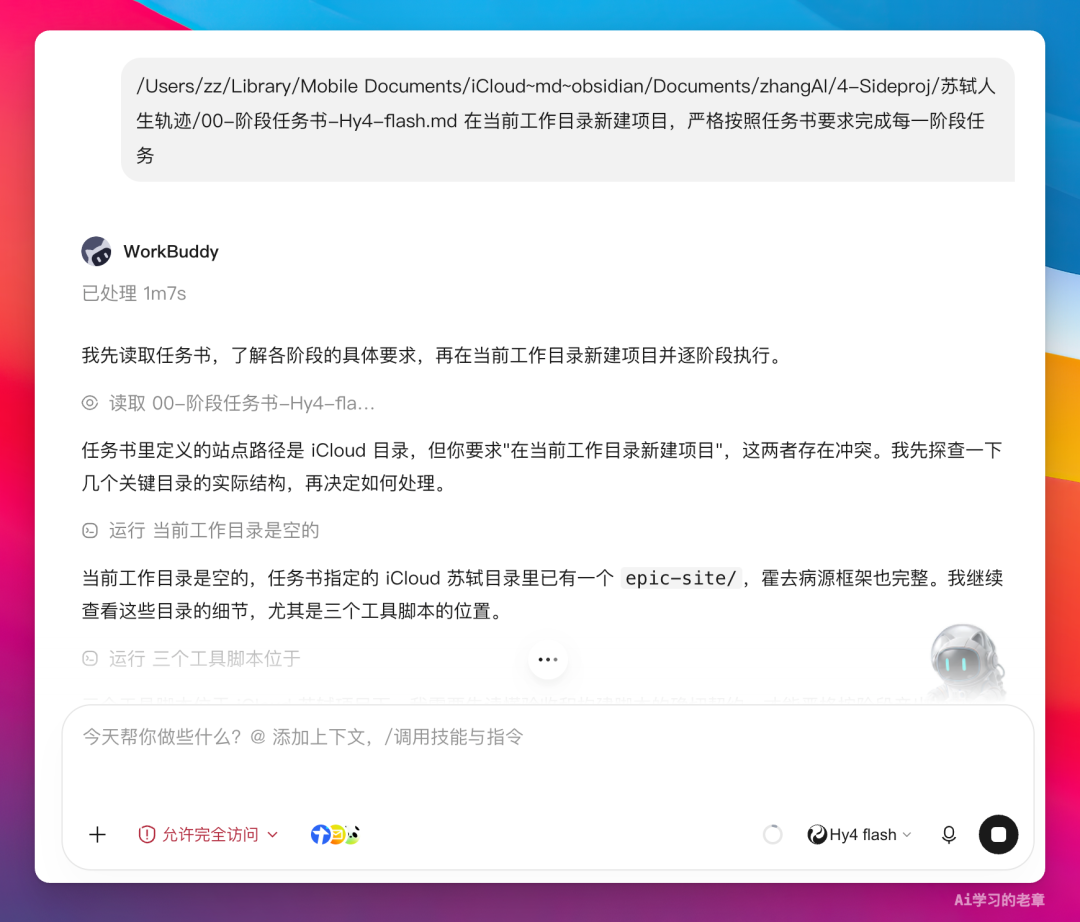
然后就是等待 Hy4 flash 努力工作了,这里面有大量资料收集、整理、清洗,要大海捞针从资料中找到适合在地图中展示的,我是不舍得让旗舰模型干这活儿,太耗 Token 了
这里面还有很多地方它不确定,加了待考证清单
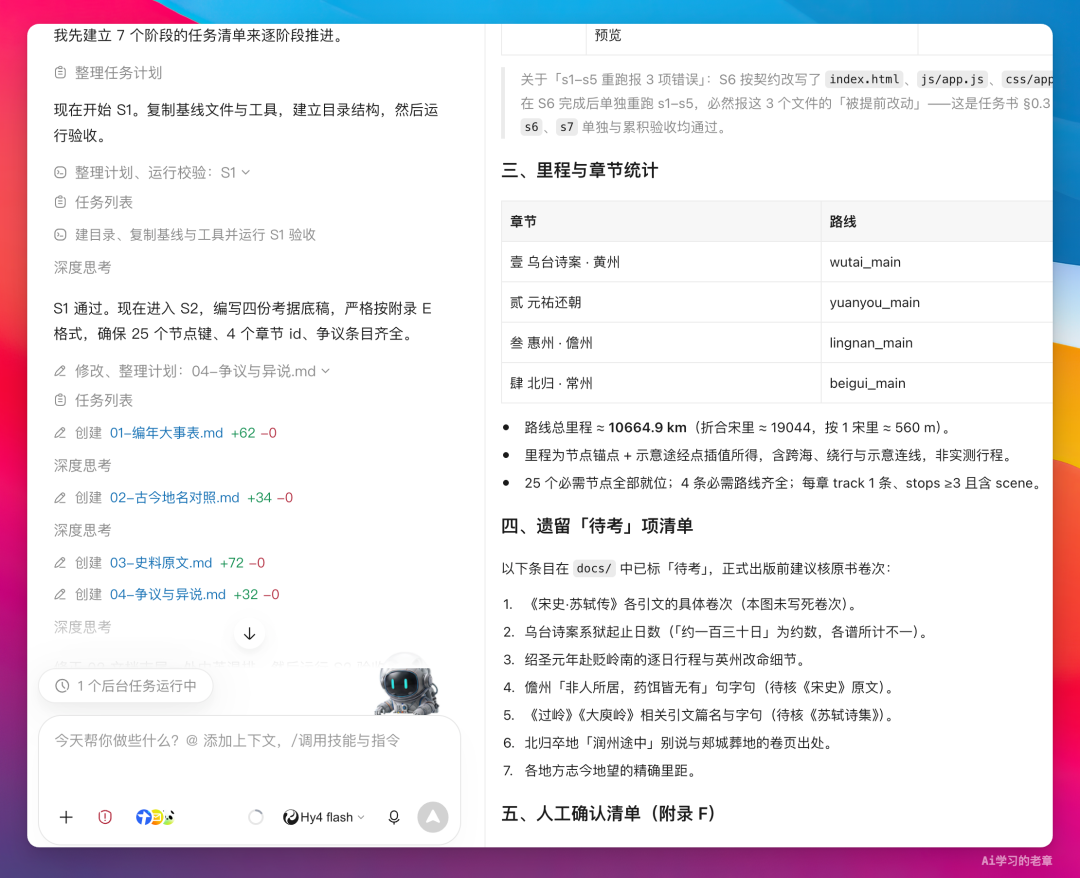
具体开发阶段倒是还好,毕竟有 Hy4 打基础
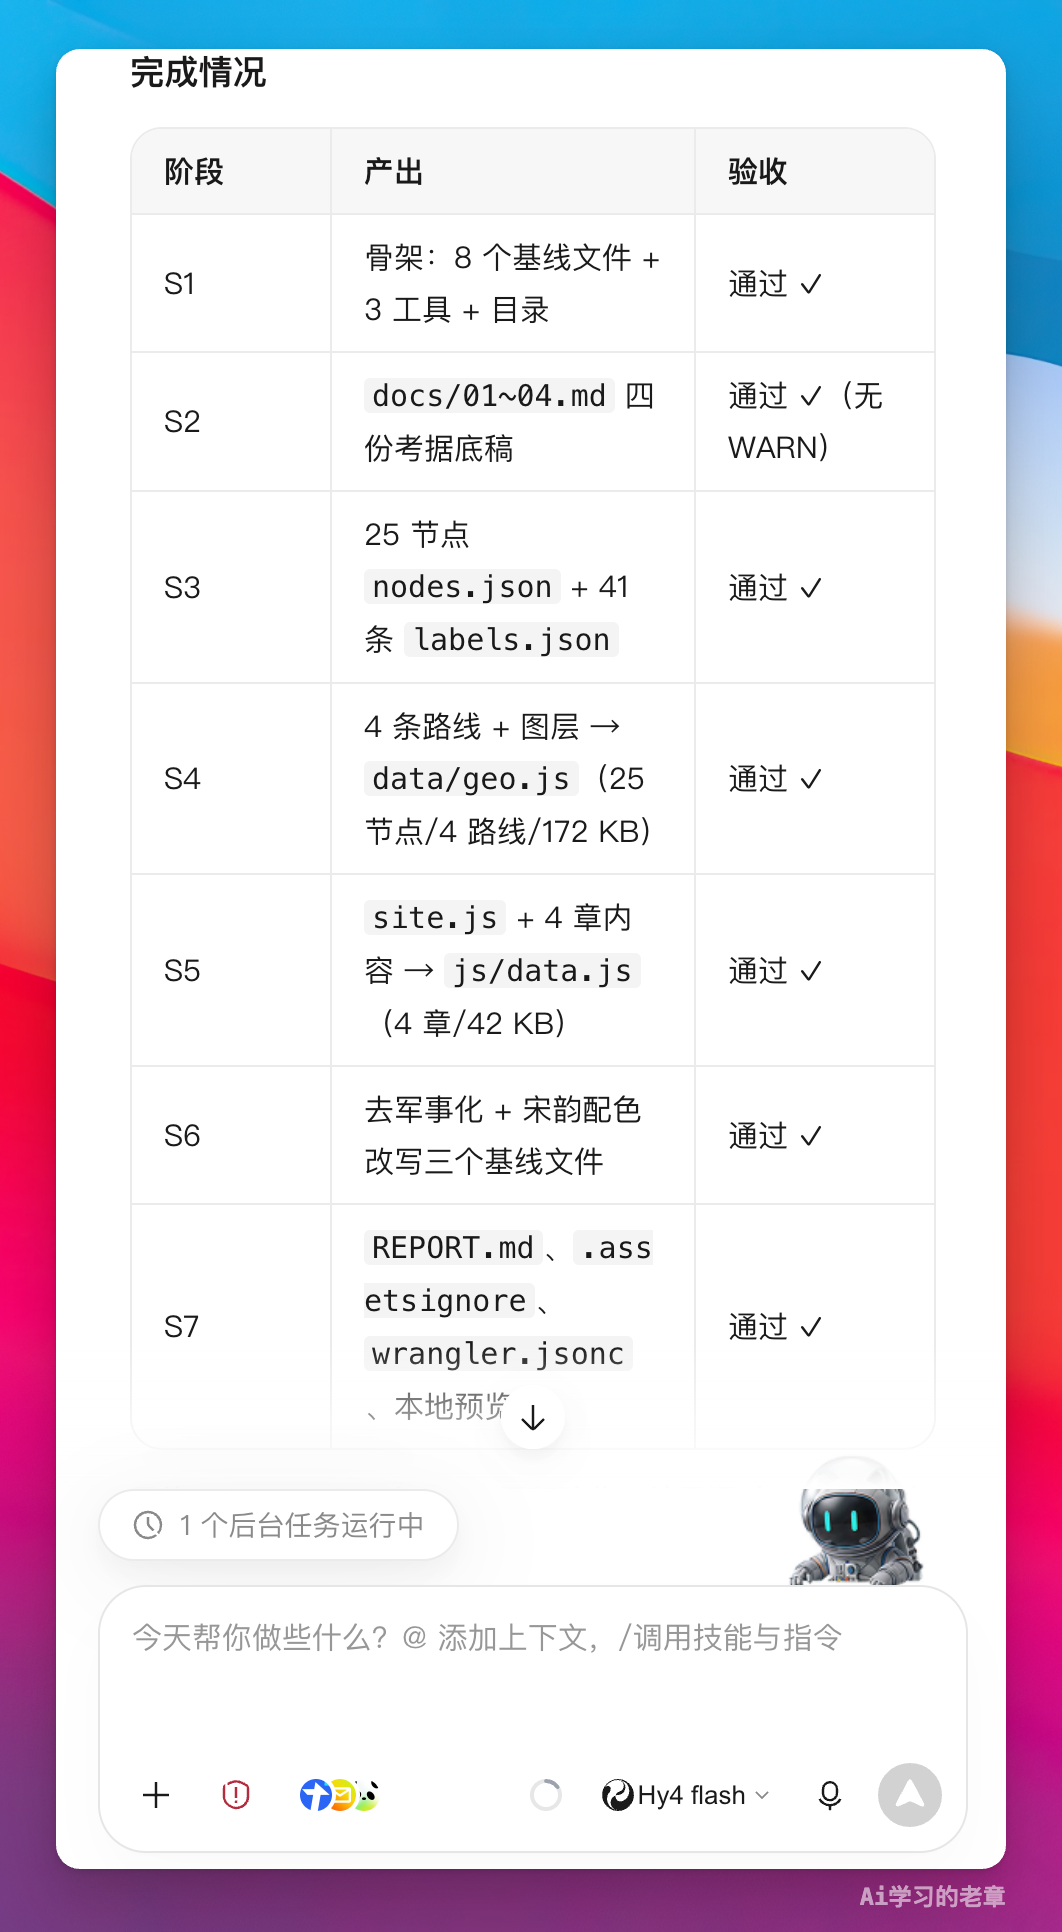
看下成品,很完美
总结
我个人觉得 Hy4 flash 模型能力还不错,很适合日常任务。混元官方给的建议场景本身也很务实:深度搜索、海量文档处理、PPT 生成、轻量前端展示、日常自动化 Agent
最近一段时间 Hy4 flash 将是我日常高频任务的默认模型,不仅是因为 11 月 30 日之前免费,真的!
作者:Ai学习的老章 公众号:Ai学习的老章
本文由 @Ai学习的老章 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议
内容来自 人人都是产品经理,版权归原作者所有。
阅读原文 ↗